白翔:华科本硕博,后来当院长,拍照识字算法CRNN全球公认牛,论文被引7万次,带出博士生拿到华为天才少年最高档
AI人物 | 感受他们为世界做出的贡献
有一件事,白翔奇怪了好几年。
我们2015年底提出来CRNN算法,为什么工业界现在还在用?
这是他2020年接受采访时说的。CRNN是他和学生做的一个算法,干的事情是让电脑读出照片里的一行字。他们后来又做了好几个更稳的新算法,工业界反而不用。工业界的朋友告诉他:一般情况下,CRNN就够用了。像BAT这样的大公司,每天要处理上亿张图片。
白翔是华中科技大学的教授,2023年起当软件学院院长。他的论文在谷歌学术上被引用了7万多次,2020年那次采访时,这个数还是1.5万多。
2025年12月,IEEE公布2026年新当选的Fellow,全世界350人,中国大陆53人,他在里面,理由是"对文档图像处理和理解的贡献"。IEEE是全球最大的电子电气工程师学会,Fellow是它给会员的最高一级称号。
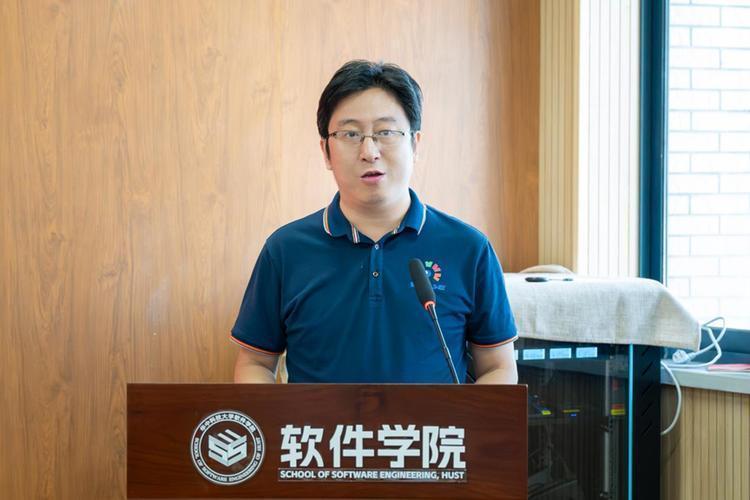
▲白翔在华中科技大学软件学院讲台上(图源:网络)
百度做了一个免费的识字工具包,叫PaddleOCR,在程序员常用的代码网站GitHub上被收藏了9万多次。它找字的那一步,从第一版用到2026年的第六版,用的都是白翔团队的算法。
拍照识字,难在街上的字
把一页打印的文件扫进电脑,再变成能复制的文字,这件事早就有人做得很好。今天很多软件还在用的开源工具Tesseract,是惠普公司1985年到1994年间开发的,后来交给谷歌接着维护。
难的是街上拍的字。
店招、路牌、菜单、商品包装上的字,有中文有英文,颜色、字体、大小各不相同,有横排的、竖排的、斜着的、弯成一圈的。背景也捣乱,研究者专门写过:树叶、砖墙、窗户、栅栏,在电脑看来都长得像字。再加上拍的人站得远、角度歪、手一抖、光线暗、玻璃反光,字就更难认。
2011年有研究者拿当时一款商用识字软件ABBYY,去认从谷歌街景里截出来的单词。每个单词还给了50个候选答案让它挑,它只认对了35%。
华科读到博士,半路改行
白翔本科、硕士、博士都在华中科技大学读。
2015年腾讯写过一篇他的人物稿,说他小时候"成绩一般,还喜欢恶作剧",可一旦迷上学习就收不住,喜欢物理和化学,"竟意外在全国数学竞赛中获得二等奖"。1999年,他考进华科的数理提高班。
读硕士时,他写了一篇论文投给《软件学报》,投出去之前,导师帮他改了至少15遍,最后还是被拒了。硕士毕业找工作,他进了一家国际知名企业的最后一轮面试,也没拿到offer。他后来说:
在找工作的时候,我发现我更喜欢研究我自己感兴趣的东西。我选择了继续攻读博士,因为我觉得前面的研究工作没有完成,这时候放弃比较可惜。
读博时,他做了一件胆子挺大的事:把一篇还没打磨好的论文草稿,直接发给了美国天普大学的Latecki教授。对方看了,主动请他去美国访问,一起做他手上的美国国家科学基金会项目。2006年到2008年,他先在天普大学待了一年多,又去加州大学洛杉矶分校联合培养了一年。博士期间,他以第一作者在TPAMI上发了3篇论文。TPAMI是计算机视觉领域分量最重的期刊之一。
2009年博士毕业,他留校任教。
他博士做的是形状方面的研究:比较两个轮廓像不像,用他的话说"相对来说比较基础"。2011年到2013年间,他特别想换个离实际用处更近的题目,想了相当一段时间,最后挑中了认街上的字。他留意到,照片里的字很多不是横平竖直的,"很多是倾斜甚至是弯曲的"。2013年,他破格升为教授。
刚进来那几年很难。他说,当时能参考的开源代码非常少,走了不少弯路,"这也是之后我们开源了多篇论文源码的重要原因"。他跟学生强调最多的一句是:
不要着急写论文,要静下心来解决实际问题。
不切字,从左往右读
在CRNN之前,电脑认一个单词,常见的办法是先切:把单词里的字母一个个找出来、切开,再一个一个地认。字挨得紧、斜着、粘在一起,切错一刀,后面全错。
还有一种办法是不切,把整个单词当成一张图来认,可英文单词就有好几万个,要一个个记住。换成中文,字和字能组成的词多到数不过来,这条路走不通。
2015年7月,白翔和他的学生石葆光、姚聪把CRNN的论文挂上了网,石葆光是第一作者。它的办法是不切字,像人用手指着一行字读那样,从左往右一小条一小条地看过去,每一小条都猜一下"这里是什么字母"。
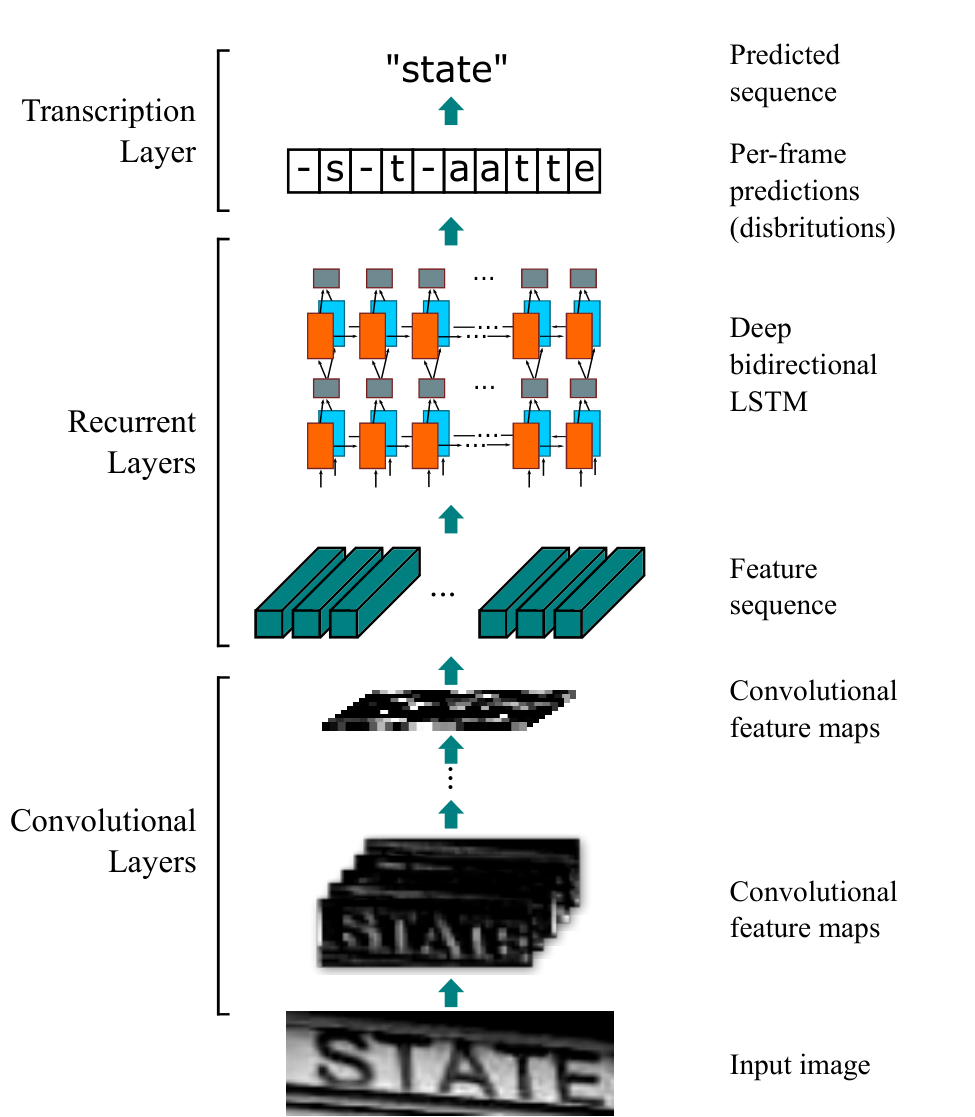
▲论文里的例子:最下面是路牌上拍到的STATE,往上是电脑一层层提取的特征,最上面一行是它从左往右每一小条的猜测(图源:Shi、Bai、Yao,CRNN论文图1)
读STATE这个词,它每一小条的猜测排出来是"-s-t-aatte",横杠的意思是"这一条什么都不是"。最后一步,把连着重复的字母并成一个,再去掉横杠,就得到了state。
这样做有两个好处。一是训练的时候,只要告诉电脑"这张图上写的是state",不用一个个标出每个字母在哪,省下大量人工。二是它不靠背单词表,电话号码这种不成词的一串数字也能读。
整个模型只有33MB,差不多是手机里十来张照片的大小,论文里写着,它"可以很容易装进手机"。
还是谷歌街景那批单词,还是给50个候选答案,ABBYY只认对三成多,CRNN认对了96.4%。
论文里还顺手做了个实验:认五线谱。拿手机对着乐谱书拍下来的谱子,两款商用识谱软件整段认对的比例是43.5%和20.4%,CRNN是84.0%。
先得找到字在哪
一张照片里,字往往只占一小块。读之前,电脑得先找出字在哪。
白翔团队2019年底挂出的DB算法,先给照片上每个点打一个"像不像字"的分,再划一条线:分数过线的连成一片,就是一块字。以前这条线全图统一划,字的边缘、两行字挨着的地方,常常划不准。DB让照片上每个地方自己学着定这条线该划多高。这篇论文的第一作者是他的博士生廖明辉,2021年毕业时拿到华为"天才少年"最高一档,年薪201万。
前面说的百度PaddleOCR,2020年发布第一版时写得清清楚楚:找字用DB,读字用CRNN。从第三版起,读字那一步换成了百度自己的新算法,找字的DB一直没换。全世界程序员最常用的图像处理工具库OpenCV,文字检测也内置了DB,读字给的预训练模型是CRNN。
华科的官方介绍里写着,白翔团队的文字检测与识别技术,用在华为、微信、阿里巴巴、美团等公司的产品里。
大模型会读字了,还卡在哪
这两年,ChatGPT这样的大模型也能看图了,拍张照片问它上面写的什么,它多半答得出来。专门认字的模型,还有必要吗?
2023年,白翔团队做了一套考卷,专门考大模型读字,叫OCRBench。
给大模型看一张写着Message的图,它认得出来。把字母顺序打乱,变成egaesMs,它就认不出了。这样打乱以后,大模型的准确率平均掉了57%,专门认字的模型只掉了4.6%。
原因是两种模型读字的方法不一样。专门认字的模型是一个字一个字看出来的;大模型更多是靠"这里大概是个什么词"猜出来的。字一旦不成词,猜就不灵了。
中文招牌更难。考卷里有一组中文招牌,测了7个大模型,7个都是0分,专门认中文的模型是94.8分。
论文的结论是:大模型离专门认字的模型还差得远,专门的方法还少不了,何况它们用的算力和数据都少得多。
让电脑读甲骨文
能读街上的字,能不能读三千多年前的字?
甲骨文发现了4500多个不同的字,认出来、找到对应现代汉字的,只有一千多个,剩下的三分之二还是谜。
白翔团队试了一个新办法:不让电脑直接说"这是什么字",而是给它一个甲骨文字形,让它画出这个字今天大概长什么样,再交给识字软件去读。训练时,它学的是甲骨文和现代汉字在偏旁部件上的对应关系;测试用的字,都是训练时没见过的。
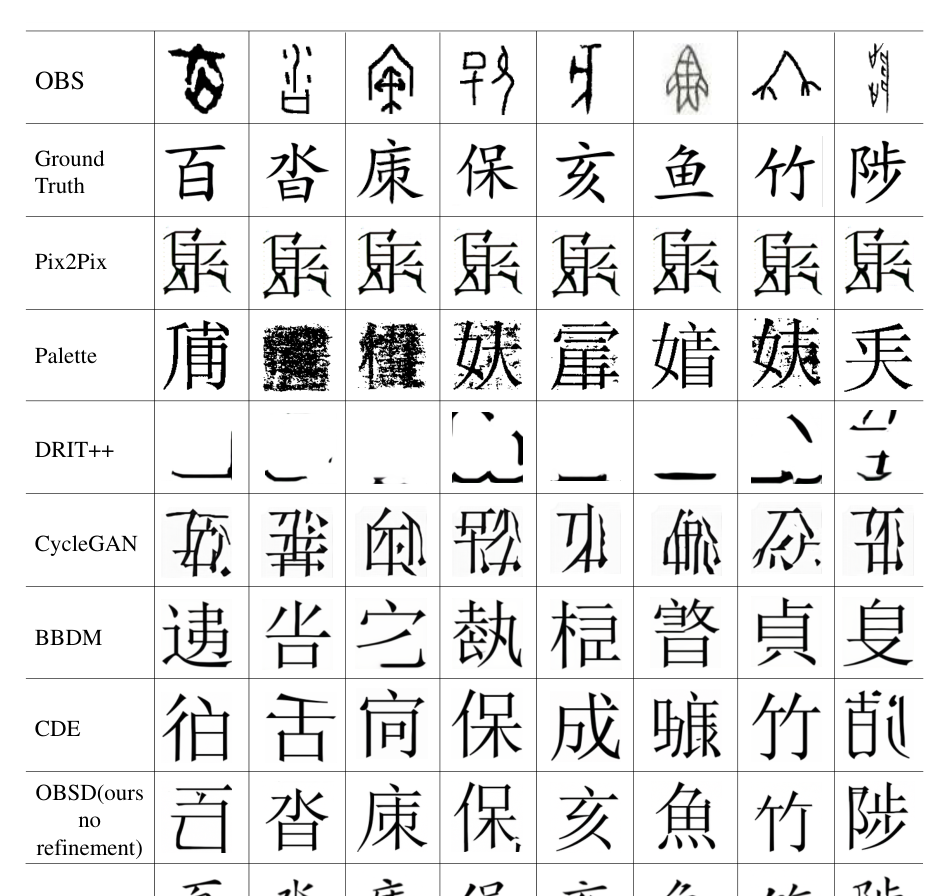
▲第一行是8个甲骨文字,第二行是对应的现代汉字,最后一行是这个方法画出来的字;中间几行是别的方法画的,大多不成字(图源:Guan等,甲骨文论文图9)
第一次画,就有41%画对了。同一个字让它画10次,画对的比例升到80%。
这篇论文拿下了2024年ACL的最佳论文。ACL是"让电脑理解人类语言"这个领域最重要的国际会议,那年收到约4835篇投稿,最佳论文评了7篇。第一作者管海粟是华科2021级的本科生,按学校的说法,他在白翔和刘禹良两位老师的指导下做古文字研究。上台领奖的,是刘禹良和管海粟。
论文最后也说了实话:这套分数只能拿已经认出来的字来打。真正没人认得的字,画出来对不对,没有标准答案,最后还得请甲骨文专家来判断。
2016年起,安阳的中国文字博物馆悬赏,破译一个甲骨文字,奖10万元。到2025年,领到这笔奖金的,只有三位古文字学者。
本文由 NOAI Club(noaiclub.cn)整理,作者:带孩子玩AI的江哥。发布于 2026-11-06。