何恺明:高考满分进清华,MIT终身副教授,ResNet成为21世纪被引用最多的论文
AI人物 | 感受他们为世界做出的贡献
孩子学AI、准备NOAI,迟早要学一个叫PyTorch的工具。NOAI的学术大纲里写明了,要"掌握PyTorch基础语法"。
在PyTorch里搭神经网络,最常用的是全连接层和卷积层。每建好一层,程序都会自动调用一个函数,给这一层的参数定好初始值。
这个函数叫kaiming_uniform_。
kaiming,就是何恺明。
2025年4月,《自然》(Nature)杂志综合五个论文数据库,给21世纪发表的论文按被引用次数排了座次。第一名是何恺明当第一作者的ResNet论文,按不同数据库算,被引用了10万到25万多次。
排在它后面的,有生物实验室测基因表达几乎人人都用的实验方法,有全世界精神科医生用的诊断手册。第7名是《Attention Is All You Need》,ChatGPT名字里那个T(Transformer)就出自这篇;第8名是2012年让深度学习火起来的AlexNet。
他现在除了在麻省理工学院(MIT)电气工程与计算机科学系教书,还兼任Google DeepMind的杰出科学家。2025年到2026年,计算机视觉的两大顶级会议ICCV、CVPR,加上机器学习顶级会议NeurIPS,三家颁的"时间检验奖"里,都有他参与的论文。这个奖专门回头看十年前的论文,发给十年后还被人人用着的那几篇。
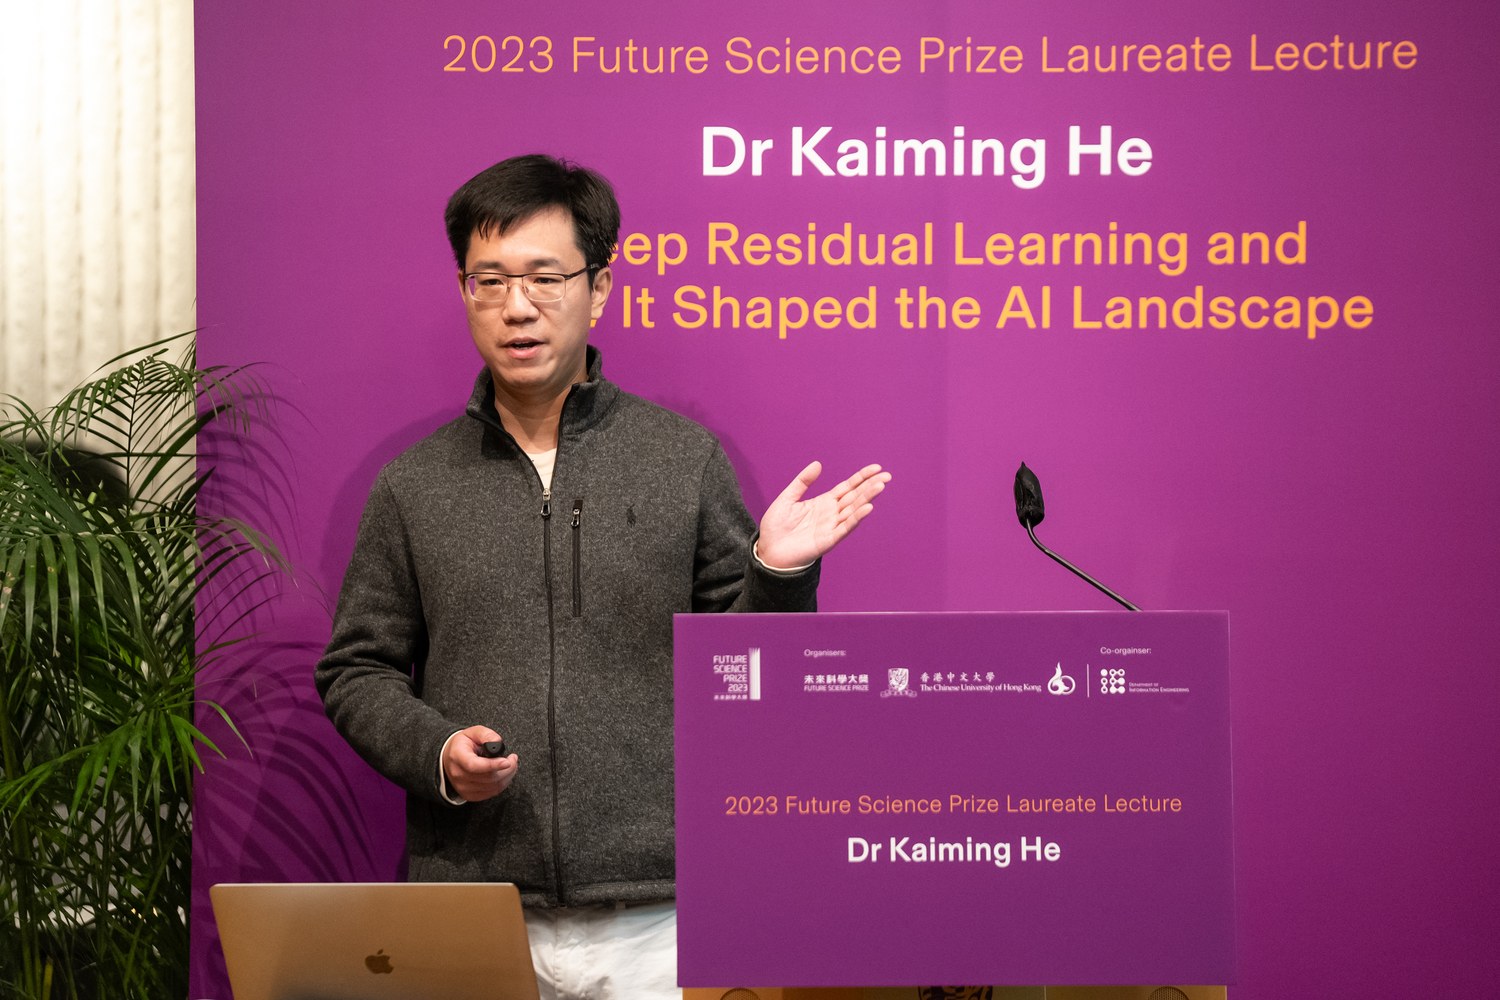
▲2023年10月,何恺明回香港中文大学做讲座,题目是"深度残差学习,以及它怎样塑造了今天的AI"(图源:香港中文大学活动相册)
ResNet管的,是AI最基本的一件本事:看一张图,认出里面是什么。
电脑认图:层数越多,认得越准
手机相册里搜"猫",这几年拍的猫一下全跳出来;拍一朵花,识花App告诉你这是月季还是蔷薇。背后干活的,多半是一个神经网络。
照片从最底下一层喂进去,每一层都在上一层算出的结果上接着算,最后一层给出答案,比如"猫,把握九成"。层叠得越多,能分辨的差别就越细,这是当时整个领域的共识。
ImageNet认图比赛的冠军,就是这样一层层往上叠的:2012年的AlexNet是8层;2014年,牛津大学的VGG做到19层,谷歌的GoogLeNet做到22层,每张图猜五次还猜不中的比例,都降到了AlexNet的一半以下。
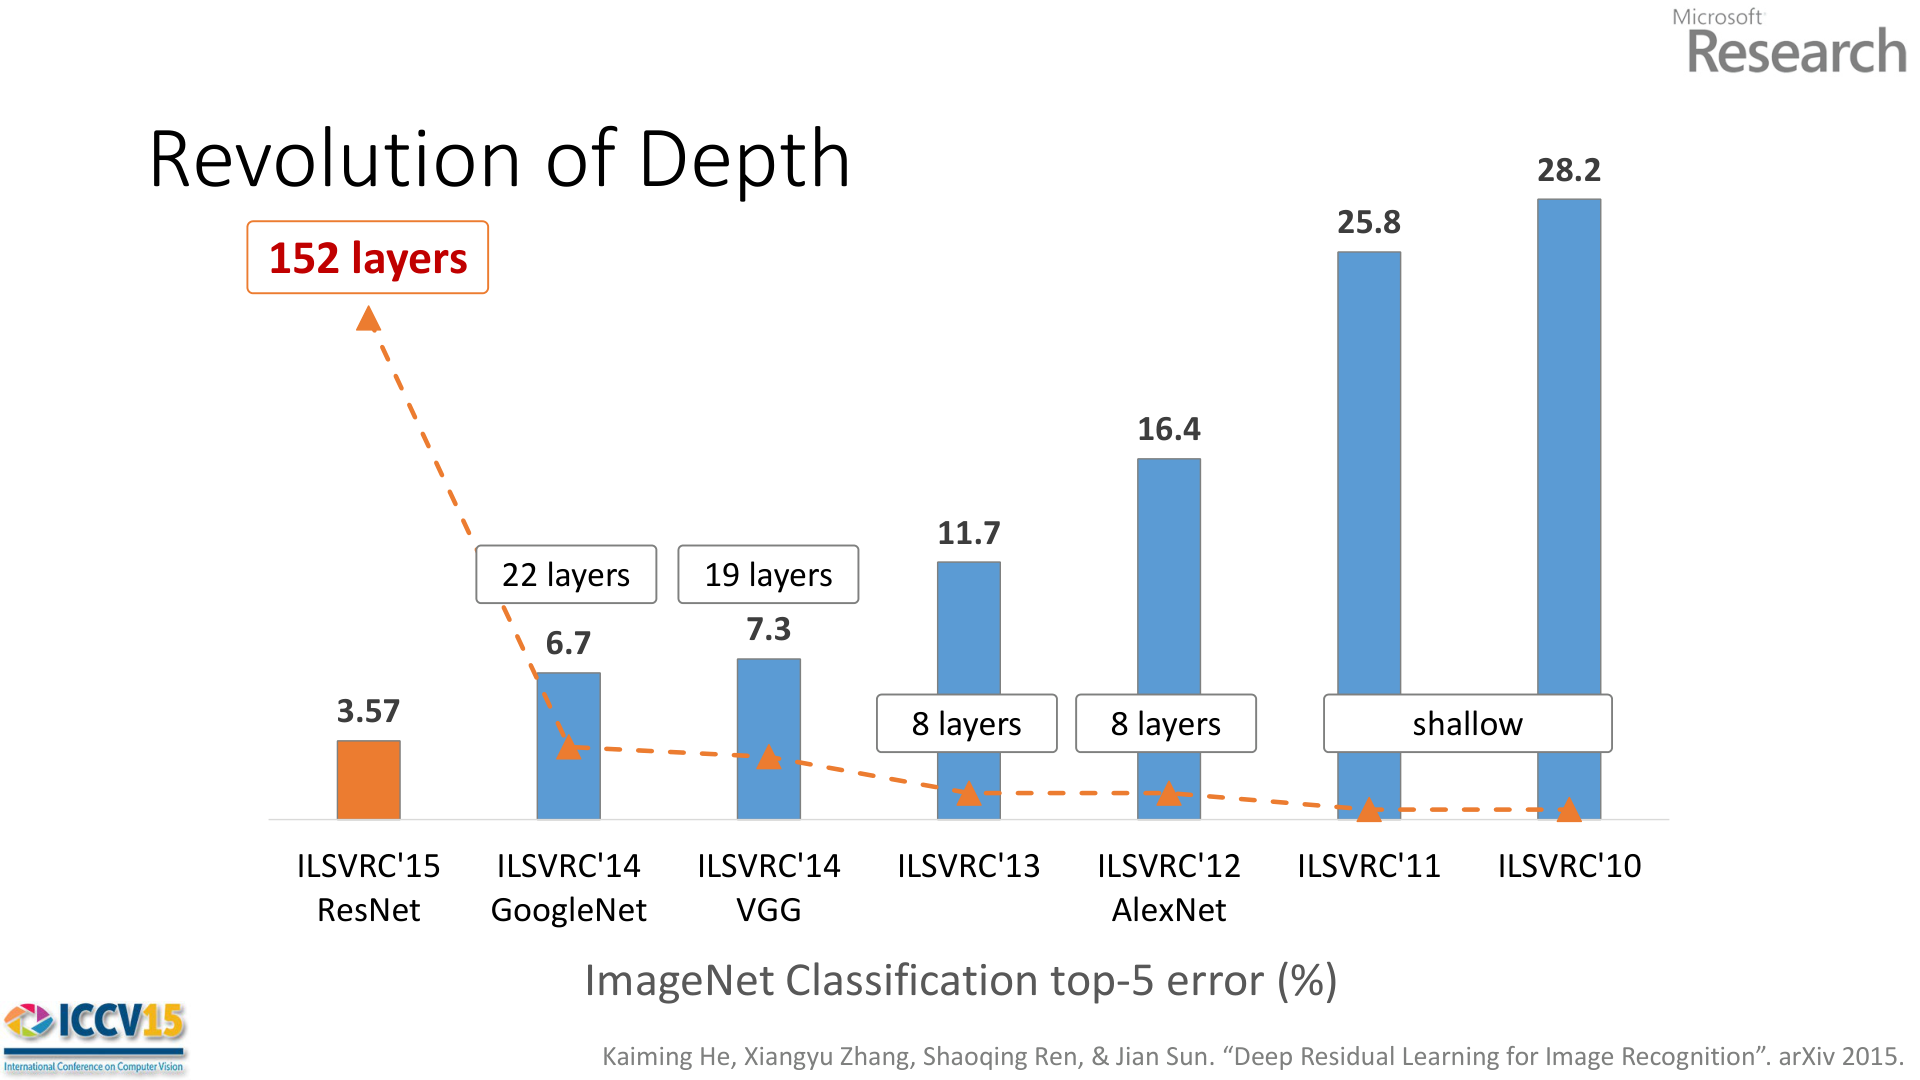
▲ImageNet比赛历年冠军的层数(方框)和错误率(柱子越矮越准),最左边那根152层的就是ResNet(图源:何恺明ICCV 2015讲稿)
可再往上叠,就不灵了。
何恺明他们在论文里做过一组对比:同样的搭法,18层的网络,只猜一次的错误率是27.94%;叠到34层,反而错了28.54%。
34层的那个,不只是考砸了。论文写得清清楚楚:在整个训练过程中,它连练习题都比18层的做得差。
ResNet:给每两层修一条近路
这事说不通。
多出来的那16层,哪怕什么都不干,只把上一层的结果原样往下传,34层的网络也该和18层的一样好。可练出来,它偏偏做不到。何恺明他们的判断是:毛病不出在层数上。让好几层网络学会"把输入原样交出去",这么简单的事,它反倒学不会。
那就别让它学,直接给它。
他们在每两层旁边修了一条近路:进来的东西原样抄一份,绕过这两层,到出口处和这两层算出的结果加在一起。这样,这两层要学的就不再是一个完整的答案,只是"在原来的基础上改多少"。用不着改,就把改动学成0,这比从头学会原样照抄容易得多。
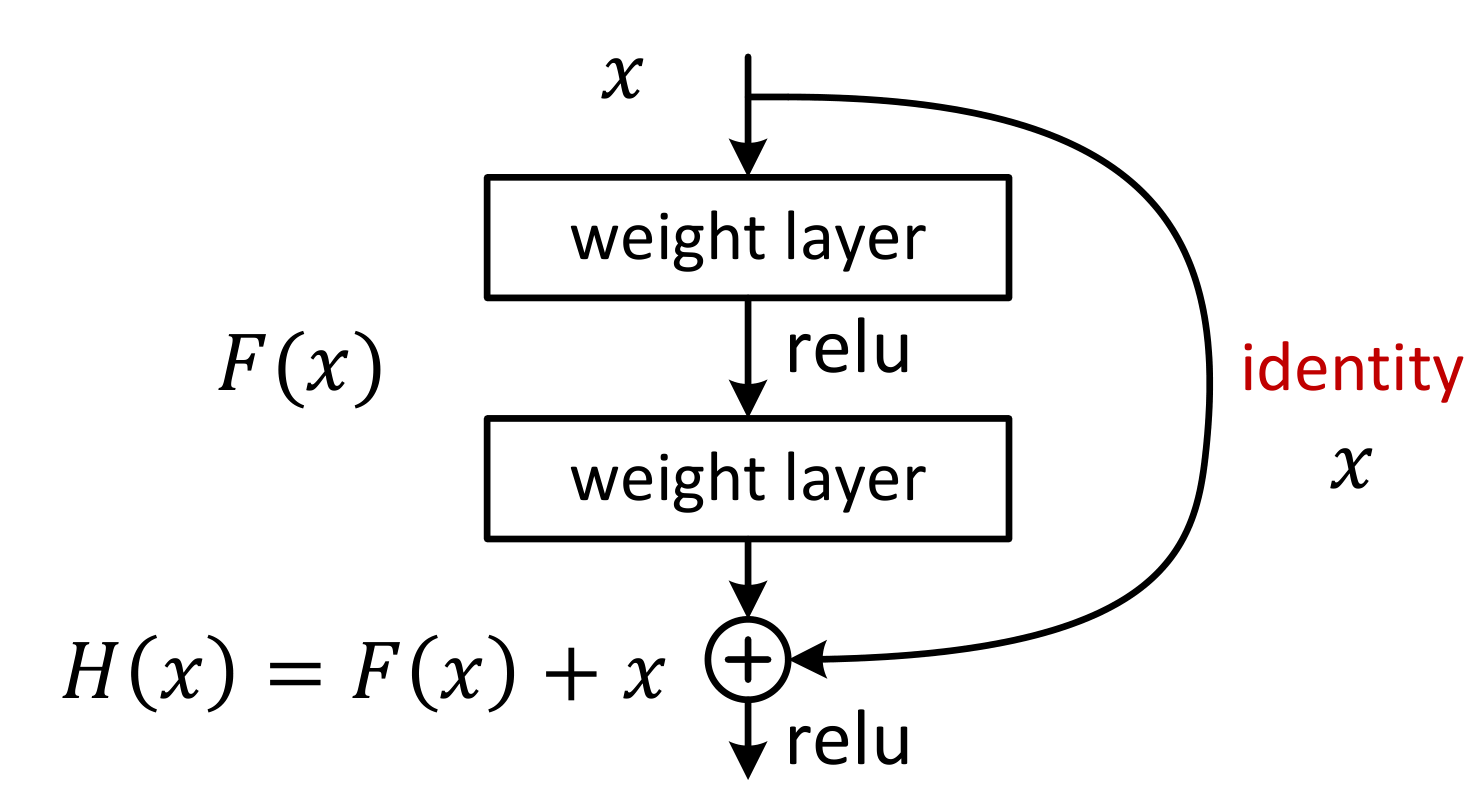
▲右边那条弧线就是近路:输入x原样绕过两层(weight layer),到出口和它们算出的结果相加(图源:何恺明ICCV 2015讲稿)
打个比方,这像改作文。普通的网络,每一层都要把整篇文章从头重写一遍,重写到第34遍,早就走了样;ResNet让每一层拿着上一稿,只用红笔在上面改,写得好的地方一个字不动,原样交上去。
加上近路,34层的错误率从28.54%降到25.03%,比18层的还低。层数的天花板一下子掀掉了:他们交出的网络有152层,比VGG深8倍,计算量反而更少,113亿次运算对VGG的196亿次。他们还试过1202层,训练起来一点不费劲。
2015年12月10日,论文挂上网。也是这个月,ImageNet比赛揭晓:ResNet每张图猜五次的错误率只有3.57%,ImageNet和另一个大型视觉比赛COCO的五个主要项目,它全拿了第一。
在这之前,2015年2月,何恺明和同一拨同事已经交出过一份4.94%的成绩,论文里写着:这是第一次超过人类水平(5.1%)。这篇论文里给参数定初始值的办法,就是PyTorch里那个kaiming函数的出处。
学画的少年,和自己吵架的博士生
何恺明1984年生在广州。2003年他考出广东高考满分,《信息时报》的记者到他家采访,他父亲"老何"讲了不少儿子小时候的事:夫妻俩都在一家企业做管理,儿子5岁就被送去少年宫学画,常常一个下午都坐在写生台前。客厅里还摆着他11岁画的一幅水彩。后来奥数班和画画的时间撞了,他只好放下画笔,画画老师很是惋惜。
同一年,《南方都市报》的记者见到的他,"双手都一直规规矩矩地放在膝盖上,记者问一句,他就答一句"。问他学习有什么秘诀,他说:"不知道啊,很多人都问过这个问题,但一直都不太清楚,可能是悟性好。"
满分到手,他的下一个计划是去桂林玩一趟,再抽时间学学英语。执信中学校长刘仕森说他"性格执着,对一个问题着迷了就会不断地去研究,直至找到答案"。
他进了清华的基础科学班,主修数学和物理。他后来写道:"在本科阶段,我并没有系统地学习过计算机方面的相关知识。"
2007年,他到香港中文大学读博,导师是汤晓鸥(后来创办了商汤科技)。面试时,汤晓鸥就跟他说,不在意他没有相关背景,所有相关的东西都是可以学的。读博期间,他去微软亚洲研究院实习,带他的是孙剑。刚到那里,他觉得"看见的每一样东西都是新的"。头一年做了几个课题,都没成功。
转机来自一款3D电脑游戏。游戏里有很多带雾的场景,雾是程序画出来的,可人一看就知道有雾。他想,人的眼睛和大脑一定有一套很管用的办法来认出雾,而且和当时所有的去雾方法都不一样。
办法做出来了,效果很好。孙剑却一直追问:它能成功,本质原因是什么?他让何恺明去研究大量没有雾的照片,最后真找出了一条规律,就是后来的"暗通道先验"。
写论文时,他"经常陷入自己和自己吵架的角色当中":每写一段,就质问自己事情到底是不是这样,有没有漏洞,要是自己当评委,看不看得懂。一稿往往要写好几天。孙剑起初一个字都不替他改,只在结构和思路上提意见,他就回去接着和自己吵。
2009年4月24日早上,他收到计算机视觉顶级会议CVPR主席发来的邮件,这篇论文得了最佳论文奖。他写道:"我反复阅读这封邮件以确认我没有理解错误。"这是CVPR创办25年来,第一次由中国人拿到这个奖。那也是他真正意义上自己写的第一篇论文。
汤晓鸥在2023年世界人工智能大会上讲起这个学生:
我一直跟何恺明开玩笑:你的一出手就到了巅峰,从此以后你的学术生涯就只能往下走了。欣喜的是,他去了微软和Facebook工作后,成绩一路走高。
2016年,他从微软去了Facebook的AI研究院,搬到美国。谢赛宁(后来成了纽约大学教授)当时在那里实习。谢赛宁在2026年3月的一档播客里回忆:何恺明刚到时不会开车,是他开车带何恺明出去吃饭,再送回家;何恺明在微软一直用Windows写程序,不会用Linux,也是他这个实习生教的。
谢赛宁还说,何恺明的论文都在截稿前一个月就写完了,剩下的一个月,一遍遍抠表格、抠每个字、每个标点。一行字要是空着大半行,他也嫌难看,至少得占满六成。
2023年10月,何恺明回香港中文大学做讲座。有听众问他:实验出了错、要全部重做的时候,真的很崩溃,他是怎么保持好奇和热情的?他说:
研究本就充满了挫折、失败和沮丧……我的生活就是这样,我有大约95%的时间都很失望,然后我会花5%的时间完成那篇论文……享受那5%的时光,如此反复。
从ChatGPT到AlphaGo,都走着这条近路
2017年,谷歌发表Transformer的论文《Attention Is All You Need》,模型里每一个子层外面都套着这样一条近路,论文注明了出处,引的就是ResNet。今天的ChatGPT、DeepSeek,都建在Transformer上。
同一年,DeepMind在《自然》上发表AlphaGo Zero,它的"大脑"是19个或39个这样带近路的模块一个摞一个堆起来的。论文做过对比:换成这种网络,棋力提高了600多个等级分。等级分差600,强的一方平均一百盘能赢九十七盘左右。
孩子要是在准备NOAI,这也是考点:NOAI 2027学术大纲讲计算机视觉,图像分类的代表模型,点名的就是ResNet。
ResNet的四位作者是何恺明、张祥雨、任少卿、孙剑。2022年6月14日,孙剑去世。
2023年,未来科学大奖把"数学与计算机科学奖"颁给ResNet,获奖名单上写着:何恺明、孙剑(已故)、任少卿、张祥雨。2025年,NeurIPS的时间检验奖颁给Faster R-CNN,作者里也有孙剑。官方博客引了另外三位作者写给他的话:他是人工智能、尤其是计算机视觉领域的先驱和奠基人物。
2026年,ResNet拿下CVPR的时间检验奖。获奖名单上,还是那四个名字。
认得出,不等于看懂了
ResNet让电脑认图比人还准,可它认的方式,和人不一样。
2019年,德国图宾根大学的一组研究者拿一张猫的照片,把猫身上的毛换成大象皮的纹理,轮廓还是那只猫。人一看就知道是猫。ResNet-50(ResNet的50层版本)的答案是"印度象",把握63.9%,"猫"连前三名都没进。
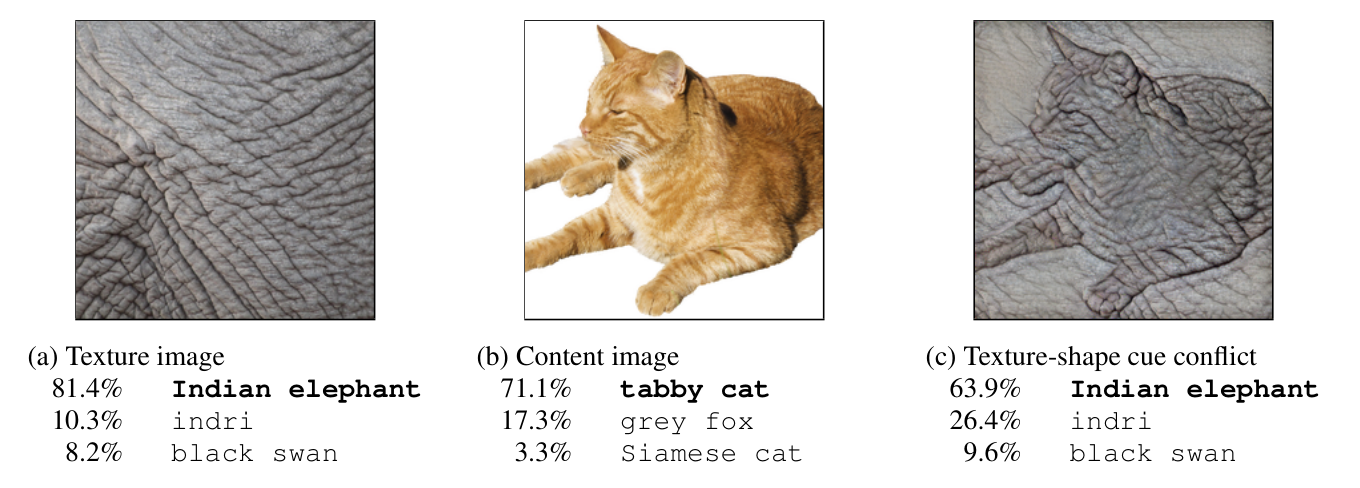
▲左:大象皮,模型认作印度象;中:一只猫,模型认作虎斑猫;右:猫的轮廓配上大象皮,模型还是认作印度象(图源:Geirhos等,ICLR 2019)
他们拿一批这样形状和纹理"打架"的图去测:人按形状判断的占95.9%,ResNet-50只有22.1%,剩下的全是看花纹认的。
同一年,MIT和IBM的研究者请网友在自己家里拍了5万张家用物品的照片,故意侧着放,从怪角度拍,摆在乱糟糟的房间里。最顶尖的识图模型拿这些照片一测,成绩掉了四成多。
还有一个麻烦:电脑学认图,得先有人一张张标好答案。ImageNet那上千万张图,就是全世界几万人一张张标出来的。
何恺明后来的工作,好几项就冲着这件事去。2021年11月,他和同事发表MAE:把一张图切成许多小块,随机遮住75%,让模型自己把缺掉的部分补回来。答案就在图里,用不着人标。
做完形填空的语言模型BERT,一句话只挖掉15%的词。图片敢挖掉75%,是因为相邻的小块太像了,挖少了,模型照着旁边就能猜中,学不到东西。先不看任何标签练一遍,再用标好的图微调,MAE认图的准确率做到87.8%,在当时只用ImageNet这一个图库的方法里排第一。
2024年,他到MIT任教,研究的重心转向让电脑生成图像。2026年6月,他和5个本科生一起发了一篇文生图的论文,其中的周康阳,是2024年国际信息学奥赛(IOI)的满分冠军。
2025年12月,Faster R-CNN在NeurIPS领时间检验奖,何恺明上台做报告,讲视觉目标检测这三十年。讲到1996年一篇用神经网络找人脸的论文,他在幻灯片上标了一句:这是我读的第一篇计算机视觉论文。
2009年,他自己写的第一篇论文,是教电脑把照片里的雾去掉。
那场报告的最后一页,他写的是:Into the fog. No oracle map. Is there even a destination?
驶入迷雾,没有现成的地图,连终点在不在都不知道。
本文由 NOAI Club(noaiclub.cn)整理,作者:带孩子玩AI的江哥。发布于 2026-10-31。