莫斯科国立Kirillov,Meta一键抠图模型SAM一作,后带队ChatGPT多模态
AI人物 | 感受他们为世界做出的贡献
你在PPT里抠过图吗?
选中一张照片,点"删除背景",在要留下的东西周围拉一个框,背景就没了。哪里没抠干净,再拿笔点几下。
这个按钮是2010年版的Office加进去的。微软研究院的官方页面上写着:它底层的算法,叫GrabCut。
GrabCut是2004年在微软剑桥研究院做出来的,论文第一作者叫Carsten Rother。论文第一张图的图注只有两句:用户在物体周围随手拉一个框,物体就被自动抠出来了。
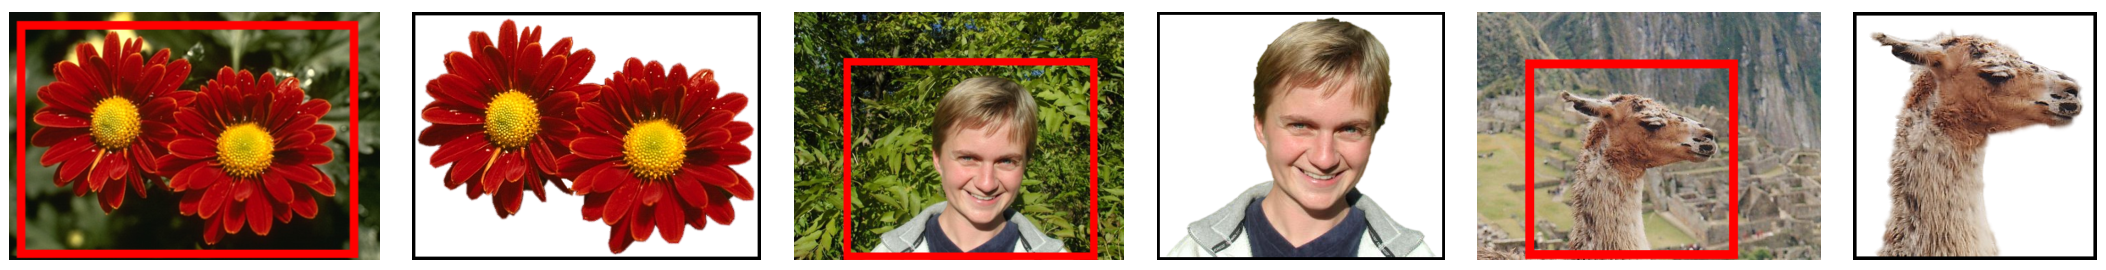
▲红框是人拉的,旁边是GrabCut自动抠出来的结果(图源:Rother等,GrabCut论文图1,SIGGRAPH 2004)
后来Rother离开微软,到德国的大学当了教授。他带过一个从莫斯科来的博士生,叫Alexander Kirillov。
2023年4月5日,学生交出了自己的抠图工具。Meta发布了一个模型,名字起得很大:Segment Anything,分割一切,简称SAM。
框都不用拉了。在照片上随便点一下,它就把你点中的那样东西,沿着轮廓完整地抠出来。
论文12位作者,Kirillov排在第一位,他是共同第一作者,也是整个项目的负责人。SAM的代码放在GitHub上,有5.5万多颗星;论文被引用两万六千多次。他本人的论文,一共被引用超过9万次。
做完SAM,他去了OpenAI,带多模态研究组,做的是GPT-4o和ChatGPT的高级语音模式。
把一样东西沿着边,一个点一个点地从照片里分出来,这件本事,行话叫"图像分割"。手机人像模式把背景虚化,视频会议换背景,医生在片子上勾出肿瘤,靠的都是它。
抠图,比框出来难在哪
在照片里找东西,电脑给一个长方形就算交差:人在这个框里。
抠图不行。一张照片是几百万个小点(像素)拼起来的,抠图要对每一个点都说清楚:你属于这个人,还是属于背景?框里那些其实是草地的点,要一个个剔出去。
2019年,Kirillov和何恺明、Ross Girshick、导师Rother,还有Facebook的Piotr Dollár一起发了一篇论文,叫《全景分割》。他们把照片里的东西分成两种:一种能数,人、动物、工具;一种数不清,草地、天空、马路。全景分割要求,每个点既要说出是什么,还要说出是哪一个:这是车,而且是左边第二辆。
这件事,连人都做不齐。论文里有一张图:同一辆车,一位标注员标成了一辆,另一位拆成了两辆。
就算认对了,边也难描。当时最常用的Mask R-CNN,不管东西多大,都先在一张28×28的小方格纸上画轮廓,再放大到原图上。东西一大,边就成了锯齿,手指糊成一团。
2020年,Kirillov当第一作者,和吴育昕、何恺明、Girshick发了PointRend。想法借自电脑画三维画面的渲染程序:大片颜色一样的地方,粗粗算一遍就够了,力气全花在边上。它先画一个粗轮廓,每一步把格子加密一倍,只挑最拿不准的那些点重新算。
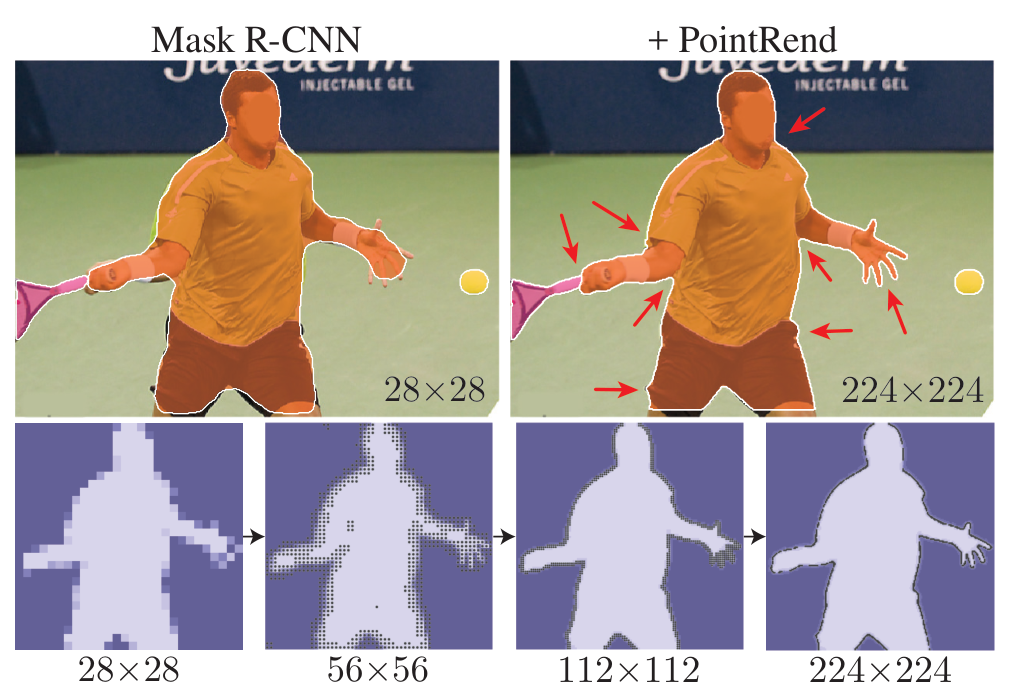
▲上排左边是在28×28格子上画的轮廓,右边是PointRend画到224×224的结果;下排是一步步加密的过程,黑点就是只在边上加算的点(图源:Kirillov等,PointRend论文图1)
画到224×224,它的计算量不到每个点都细算的三十分之一。论文也老实说,按打分只涨了一点,可肉眼一看,边界的差别一目了然。
从莫斯科到海德堡:一个只琢磨分割的博士生
Kirillov在莫斯科国立大学读的书,跟着Dmitry Vetrov和Alexander Dyakonov做毕业设计。之后他去德国海德堡大学读博士,导师就是Rother。
读博期间,他在计算机视觉顶级会议ICCV 2015上发了一篇论文,琢磨的是一个有点怪的问题:电脑抠图,能不能一次给出好几个不一样的好答案,而不是只给一个?论文拿来试的,正是"人点几下、电脑来抠"的交互式抠图。用户心里想要的是哪一个,电脑未必猜得准;多给几个,总有一个对。
2018年,他交了博士论文,107页,题目是《探索图像分割的几个方面:多样性、全局推理与全景表述》。第一个关键词是"多样性",最后一个是"全景"。
同一年,他在欧洲计算机视觉大会ECCV上组织了COCO全景分割挑战赛。题目是他在论文里定的,考卷也是他张罗出的。
博士毕业,他进了Facebook人工智能研究院(FAIR),和何恺明、Girshick、Dollár一起写了五年论文。几个人还一起维护着一套免费公开的检测和分割软件Detectron。2021年,这个团队拿到了PAMI Everingham奖,这个奖专门颁给无私地给整个视觉圈做贡献的人。
Meta的博客里引了Kirillov一句话,讲他们做这套软件时最上心的事:
我们的一个主要心思,是让往后的新探索尽可能容易。
SAM:点哪儿,抠哪儿
SAM有一个决定:不给东西起名字。项目的另一位负责人Nikhila Ravi后来在一档播客里说,他们在SAM里做的一个设计决定,就是不要类别标签。它不管这是猫还是杯子,只管"这是一样东西",你点哪儿,它就抠哪儿。
可点一下,意思往往不止一个。点在一个人背的书包上,你要的是这个人,是书包,还是书包上那个小搭扣?
SAM的办法是,三个都给。论文写道,东西套着东西,通常最多三层:整体、部分、更小的部分。所以点一次,它一次出三个答案,每个都附一个分数,说自己有几成把握。
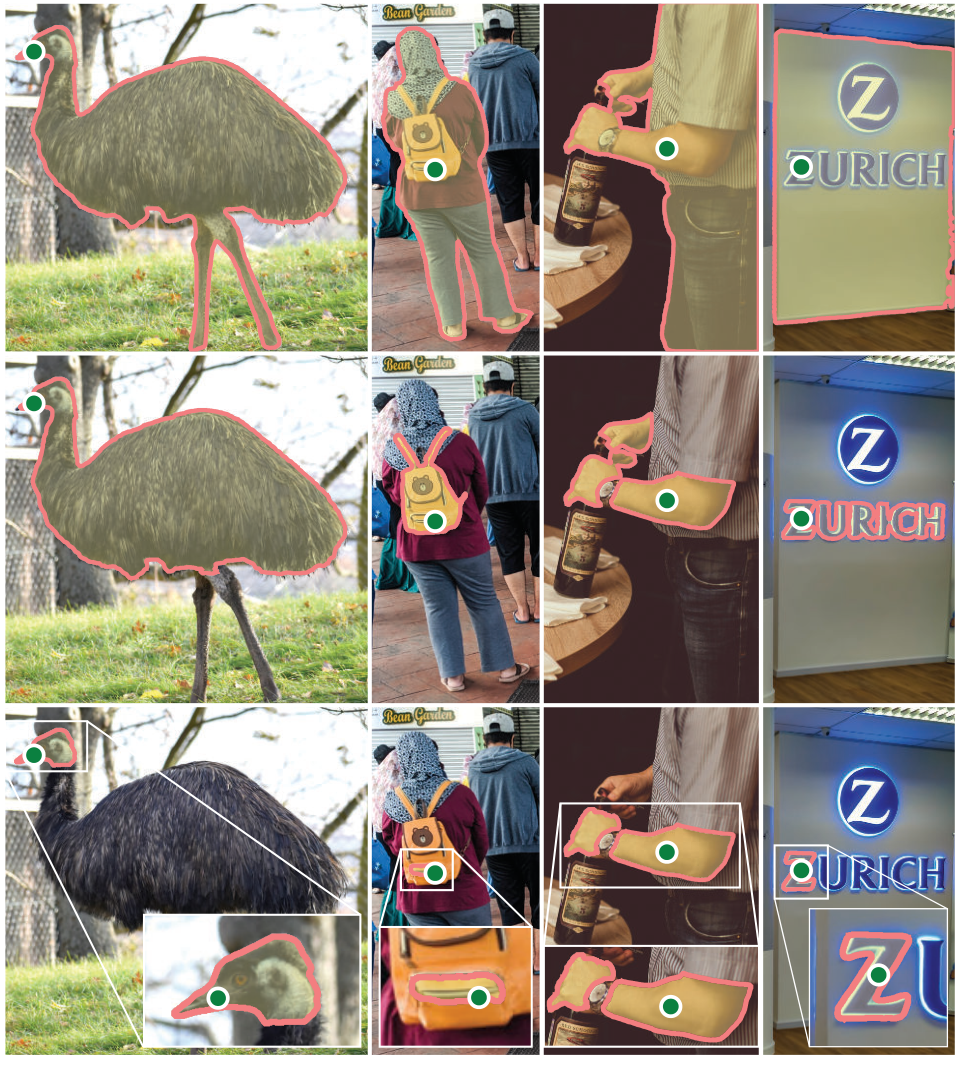
▲每一列只点了一个绿点,SAM给出三层答案:整只鸸鹋、身子、头;整个人、书包、书包上的搭扣;整块招牌、一排字母、一个Z(图源:Kirillov等,SAM论文图3)
一次给几个好答案,这个问题,他2015年读博时就琢磨过。
为了快,SAM分两步干活。一张图进来,先由一个6亿多参数的大模型从头到尾看一遍,这一步要用显卡算;之后你每点一下,只要一个很小的部分接着算,在浏览器里,用普通电脑的处理器,大约0.05秒出结果。那个大模型,事先用何恺明的MAE办法练过:把图遮住一大半,让它自己补回来。
SAM在2023年拿了ICCV的最佳论文荣誉提名。
11亿个轮廓,是怎么来的
要教AI认字,网上有现成的海量文字。要教它抠图,网上的照片大多没人描过边。
他们的办法是边标边教。
第一阶段,标注员在网页上点几下,SAM当场给出轮廓,人再用画笔和橡皮修。模型学一点,就更好用一点,前后重新训练了6次。描一样东西的时间,从34秒降到14秒,比当年标COCO数据集快6.5倍。12万张图,标出430万个轮廓。
第二阶段,模型先把有把握的东西自己标好,人只去补它漏掉的。又是18万张图、590万个轮廓。
第三阶段,人放手了。在每张图上均匀撒32×32个点,每个点都让SAM抠一遍,再挑出靠得住的。1100万张照片全这么过一遍,得到11亿个轮廓,平均每张一百个左右。
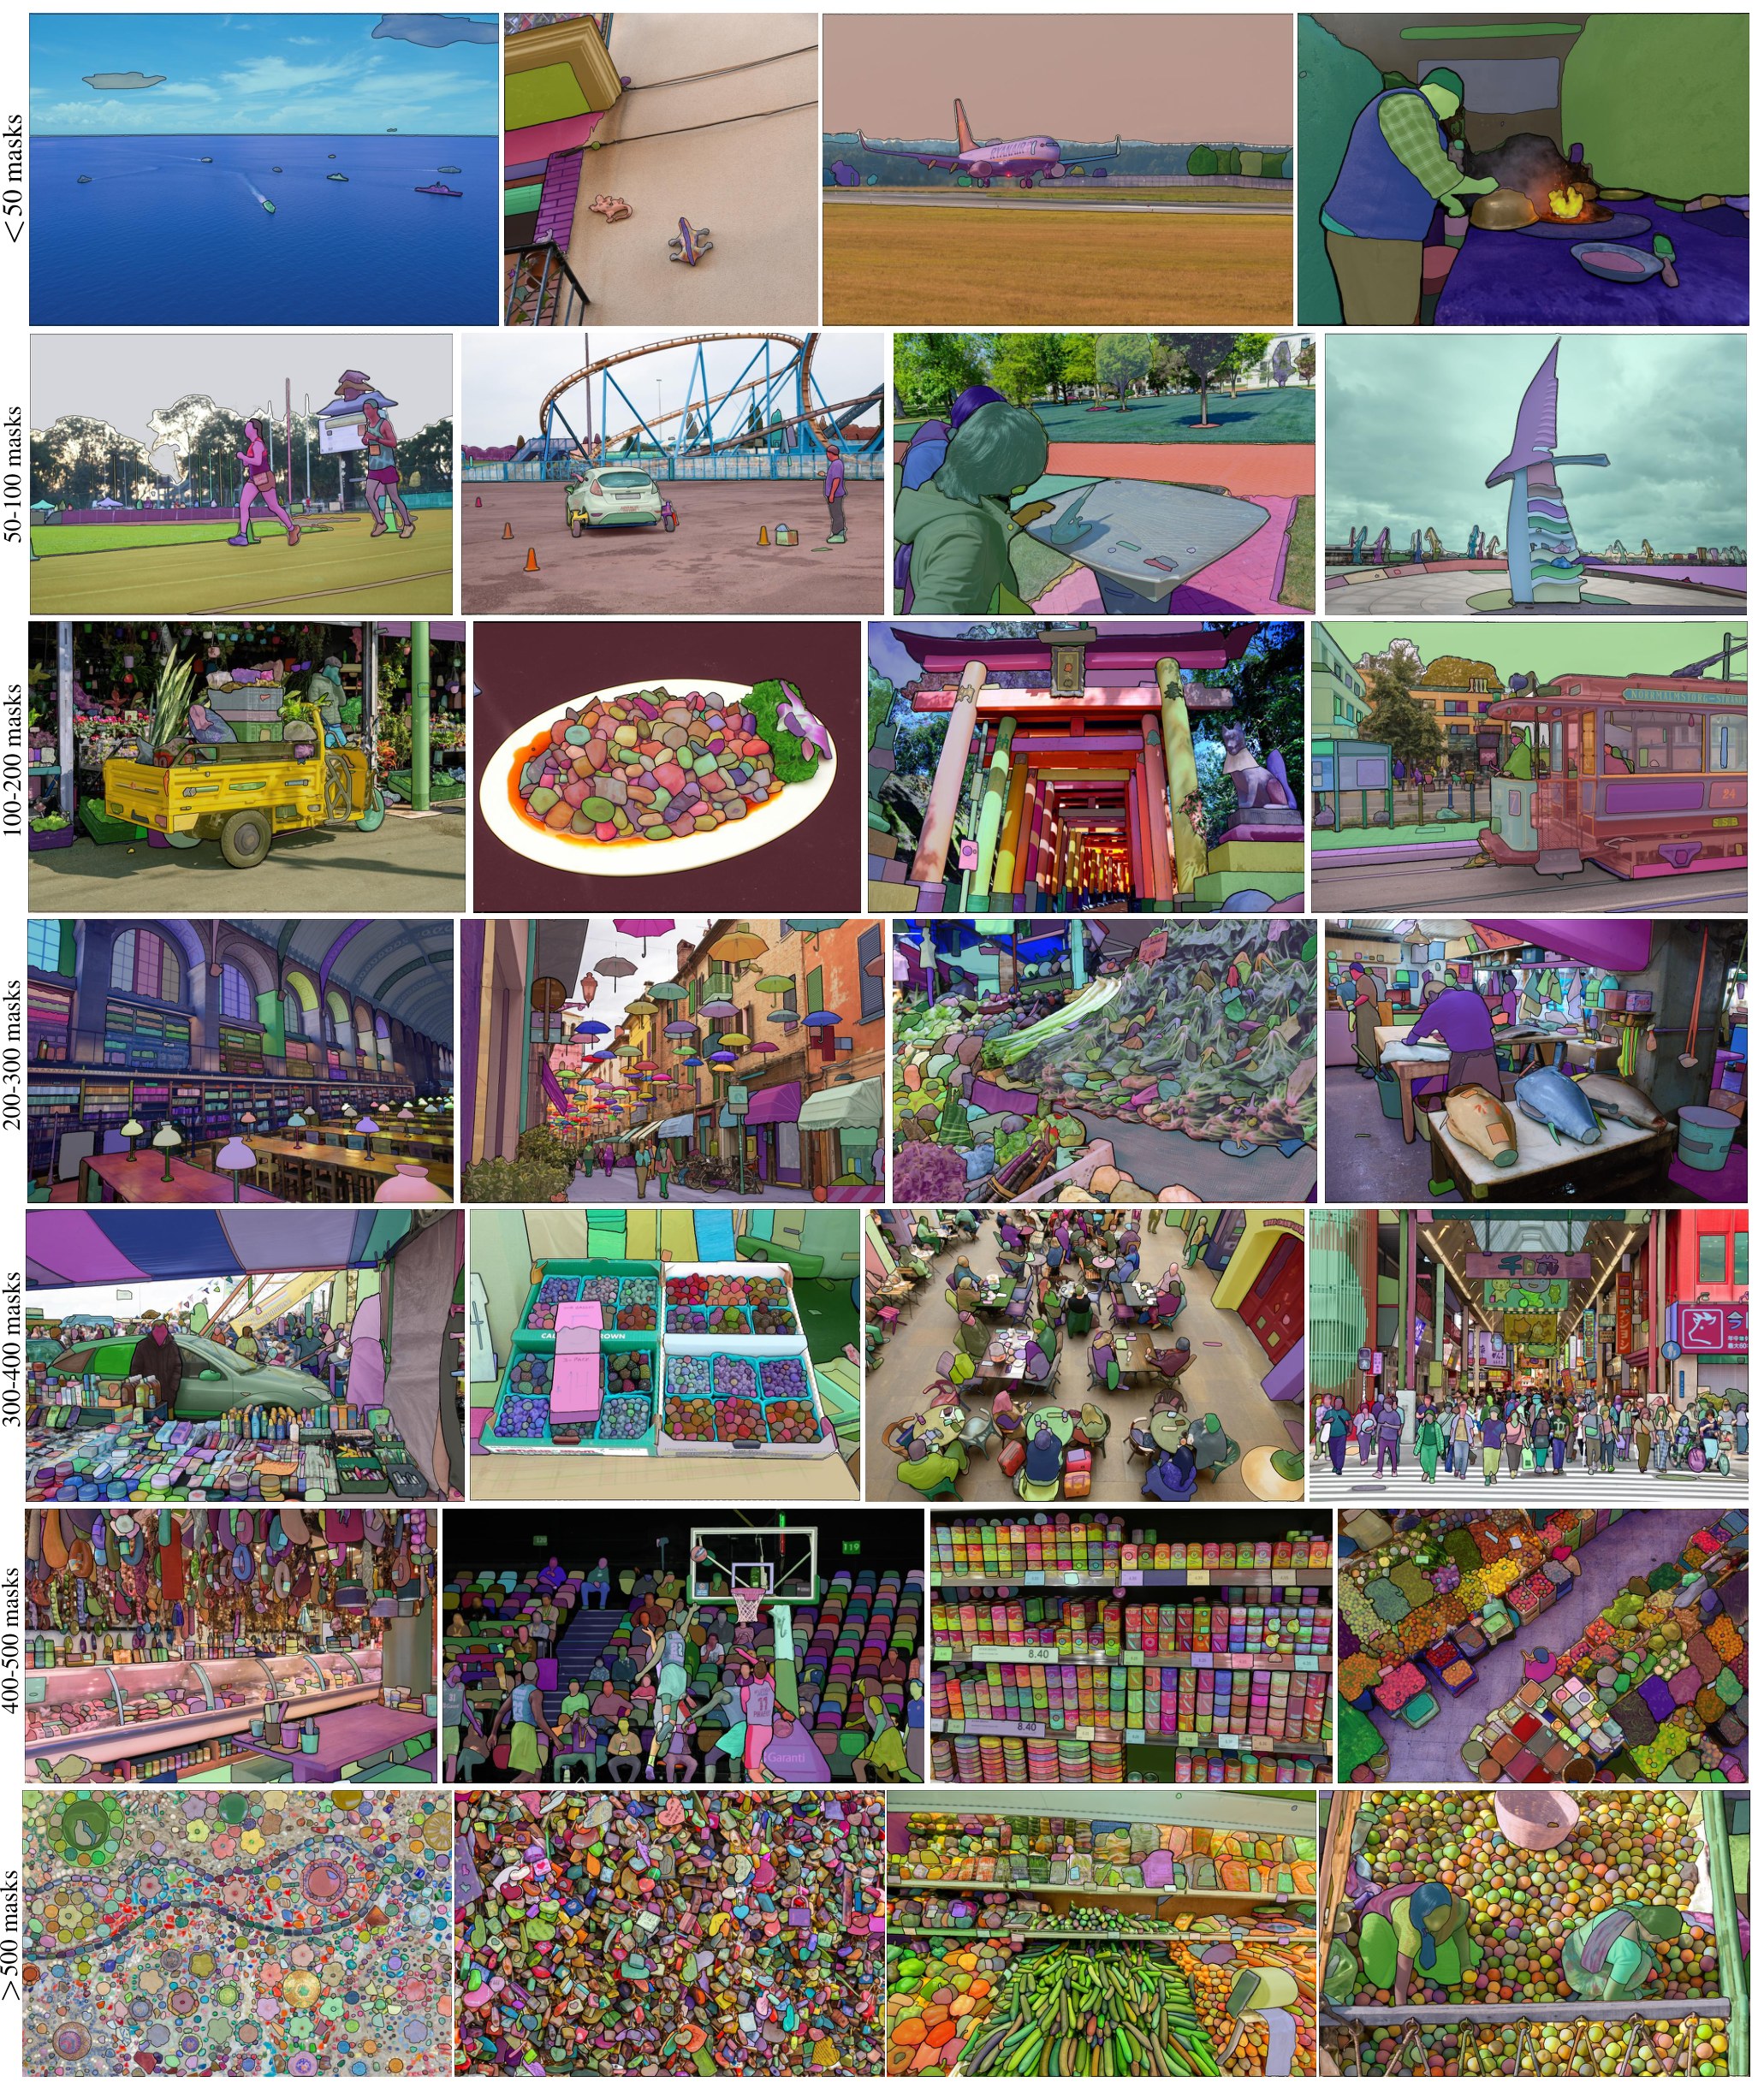
▲SAM数据集里的样例,按每张图描了多少个轮廓分档,从不到50个到500个以上;最下面一排,一颗颗糖果、一根根黄瓜都被单独描了边(图源:Kirillov等,SAM论文图2)
最后公开的数据里,99.1%的轮廓是机器自己抠的;轮廓的总数,是此前最大的同类数据集的400倍。照片是向一家和摄影师直接合作的图库买的授权,里面的人脸和车牌都打了码。
前两个阶段的人工,出自130位标注员。论文附录写着:他们都在肯尼亚,全职做这件事,平均先培训一周才上岗;研究团队每周和他们开一次会,听他们的反馈。
拿到23个它从没见过的数据集上去考,水下、显微镜、X光片、绘画都有,SAM在其中16个上胜过了当时最好的同类方法。
它还有一个网页演示,谁都能上去点。Ravi在播客里说,要不是有这个演示,机器学习圈外的人根本不会去试SAM。这个演示,本来就是他们自己的标注工具。
今天:帮人标数据、帮医生勾肿瘤
有一家专门帮人标数据的公司叫Roboflow。2024年10月,它的CEO Joseph Nelson说,SAM和后来的SAM 2,在他们平台上已经标了6000多万个轮廓;按他们自己的估算,省下的人工时间加起来约74年。
医生勾肿瘤,也用上了它。2024年,多伦多大学王波团队在《自然·通讯》上发表MedSAM:拿157万多对医学影像和轮廓,把SAM重新练了一遍,覆盖CT、核磁共振、超声等10种影像,30多种癌症。
国际赛场上也考这件事。2025年,国际人工智能奥林匹克(IOAI)在北京举行,个人赛有一道题,给的是毫米波雷达扫出来的画面,要把画面里每一个点分到五类里:背景、行李箱、椅子、人、墙。
还卡在哪:沙子里的螃蟹
SAM的论文,自己把短处写在了最后:细的东西会漏掉;有时会凭空冒出几小块;边描得不如那些放大了慢慢修的方法利落;用一句话告诉它抠什么,还只是试试,不太靠谱。
医学影像上,差距更明显。2023年,美国杜克大学的研究者拿19个医学影像数据集,考原版的SAM,看它抠出来的区域和医生画的区域能对上多少。髋关节的X光片上能到86%,脊髓的核磁共振片子上只有11%。同一个模型。
MedSAM的论文里也写,遇到边界模糊、颜色对比又弱的目标,原版SAM在几乎所有任务里都排最后。
藏起来的东西也难。2023年4月,一组中国研究者发了篇论文,标题是个问句:SAM抠不出一切?论文里有一张图,一只螃蟹趴在和它颜色差不多的沙子里,人标出来的是一整只带腿的螃蟹,SAM只抠出了一小条。
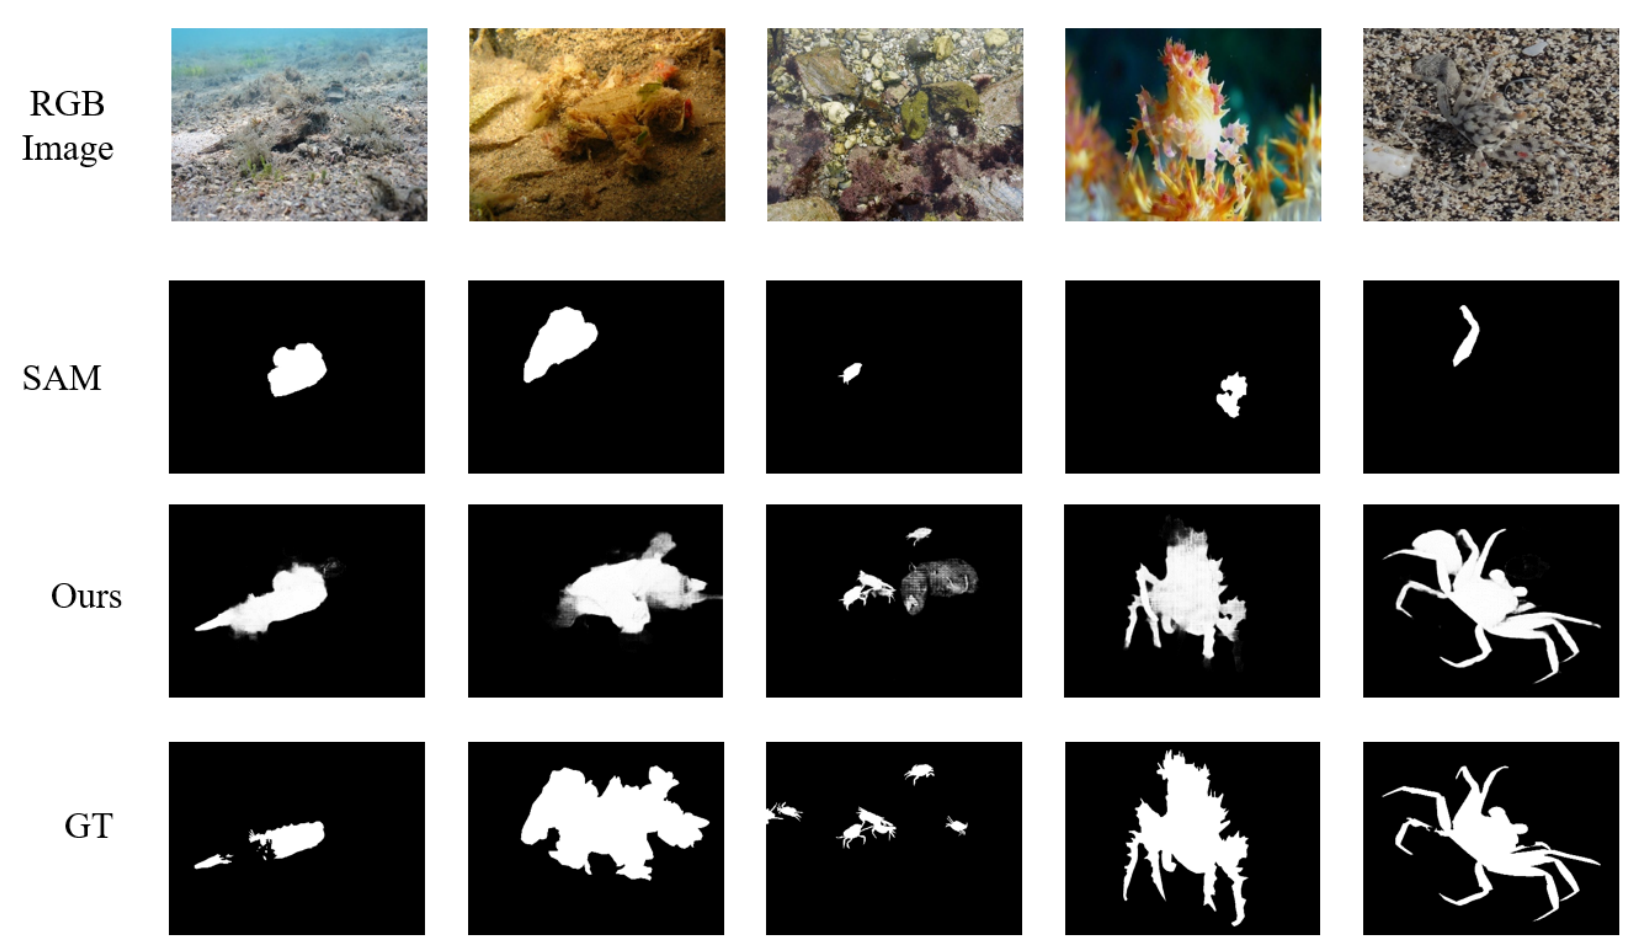
▲第一行是原图,第二行是SAM抠出的结果,最后一行是人标的正确答案;最右边那只螃蟹,SAM只抠出一小条(图源:Chen等,SAM-Adapter论文图2)
从看得见,到边看边说
他是2023年8月到的OpenAI,SAM发布才过了四个月。
2024年5月,OpenAI发布GPT-4o,能看图、能听、能开口说话。它的技术说明书里,"多模态后训练负责人"一栏,只写了一个名字:Alexander Kirillov;"语音后训练负责人"一栏的三个人里,也有他。那年7月30日,ChatGPT的高级语音模式开始推送给一部分付费用户。
2025年2月6日,他发了一条推文:
在OpenAI走完了一段很棒的旅程,我离开了,去加入一件新的、让人兴奋的、多模态的事!
没说去哪。
十几天后,谜底揭晓:OpenAI前首席技术官Mira Murati创办了Thinking Machines Lab,创始团队的名单里有他。
2026年5月11日,这家公司发布了一个研究预览,叫"交互模型"。公司的博客写,今天的模型,在你打完字、说完话之前,一直在干等,什么也感觉不到;新的模型要不停地接收声音、画面和文字,实时地想、回应、动手。
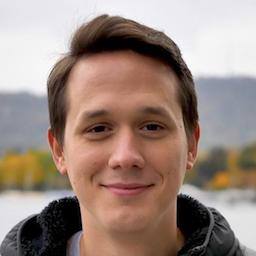
▲Alexander Kirillov(图源:本人个人主页)
他的推特简介,现在排在最前面的只有一个词:Multimodality,多模态。
本文由 NOAI Club(noaiclub.cn)整理,作者:带孩子玩AI的江哥。发布于 2026-11-01,更新于 2026-11-04。