Ross Girshick:何恺明的老搭档,R-CNN之父,论文被引50万次,创业公司被Claude母公司收购
AI人物 | 感受他们为世界做出的贡献
何恺明有一份讲稿,讲的是电脑在照片里找东西的这三十年。2025年12月,Faster R-CNN在NeurIPS大会上领时间检验奖,他代表四位作者上台,讲的就是这一份。
讲稿倒数第二页,标题是:过去几十年,我们学到了什么?
下面只有一行字,被他用横线划掉了:写目标检测的论文,拿时间检验奖。后面跟着一个笑脸。
这句玩笑,有一个人真做到了。
时间检验奖只看十年前的论文,十年过去还被大家天天用着,才轮得到它。2024年,计算机视觉顶级会议CVPR把这个奖颁给了R-CNN;2025年,另一个视觉顶会ICCV颁给Fast R-CNN,机器学习顶会NeurIPS颁给Faster R-CNN;2026年,CVPR又颁给了YOLO。
三年,四篇,作者栏里都有Ross Girshick。R-CNN他是第一作者,Fast R-CNN署名只有他一个人,另外两篇他排第三。
他的网名叫rbg,中文技术博客里常管他叫"RBG大神"。他个人主页上写着,论文被引用超过50万次。
这四篇论文做的是同一件事:教电脑在一张照片里,找出每样东西在哪、有几个。商场的摄像头数人流,自动驾驶的车找行人,要做的都是这件事。
认出是什么,还得说出在哪
何恺明讲稿的第二页,给目标检测下的定义只有两个词:识别,加定位。配图是一张生日聚会的照片,人、蛋糕、刀、酒杯、椅子,每样东西都套着一个框,框上标着它是什么、有几成把握。
认出"这是一只猫",电脑给整张图一个答案就行。找东西不一样。拿一张全班合影来说,里面有几个人,事先不知道;每个人站在哪、离镜头多远、在画面里占多大,也不知道。
老办法是拿一个框在图上挪。从左上角开始,一点一点往右、往下挪,每挪到一个位置,就问一遍:框里是不是人?挪完一轮,把框放大一点、缩小一点,再挪一遍。
电脑判断框里是不是人,看的不是图本身,是人事先设计好的几样"特征",比如每一小块里的线条都朝哪个方向。
当时找东西最权威的比赛叫PASCAL VOC,人、猫、狗、车、飞机,一共20类。2010年到2012年,各队的成绩只往前挪了一点点;到了2012年,参赛的系统干脆没比前一年强。
2008年到2012年,在PASCAL上一再赢的,是一个叫DPM的检测器和它的各种改进版。
毛笔画、旅游网站,和一个"终身成就奖"
Ross Girshick本科读的是美国布兰迪斯大学的计算机专业。2004年毕业那年,他一个人署名,在计算机图形学顶级会议SIGGRAPH上发了一张海报,题目是《电脑模拟中国毛笔画》。海报开头写:中国毛笔画里,每一笔本身就是一件艺术品。
海报里还设计了一支能让电脑"看见"的毛笔:笔杆里嵌两颗小灯,两台摄像头从两个方向盯着它(脚注里注明,这个主意是一位叫Giovanni Motta的人提的)。他补了一句:中国画怎么握笔是有规矩的,所以不用担心手把灯挡住。
毕业以后,他没有接着读书,而是去了一家旅游网站SmarterTravel写代码,干了三年,做到高级软件工程师。2007年秋天,他才回到学校,去芝加哥大学读博士,导师是Pedro Felzenszwalb。
读博第一个学期,他在主页上放了一篇小文章,题目是《用一枚硬币模拟n面骰子,或:怎么选晚饭》。开头说,两家馆子拿不定主意,抛个硬币就行;可要是有好几家呢?他真写出了一套算法,起名叫"N选晚饭"。
他还给不懂行的人写过一篇《为什么计算机视觉很难》。脚注里,他给"电脑看见了"下了个定义:能说出图里有什么就算,比如,在一只猫周围画个框,标上"猫"。
这正是他后来做了十几年的事。
读博那几年,他和导师等四个人做的检测器,就是DPM。它在PASCAL VOC上拿过2008年和2009年的检测第一名(2009年和牛津大学并列)。2010年9月,比赛主办方给它颁了一个"终身成就奖",颁奖词说,这个检测器2007年第一次参赛,几年下来,已经成了许多参赛队伍方案里的核心部件,而且一直免费公开。
那年他还是个博士生。他在主页上写:
我想这说的是PASCAL比赛的寿命,不是我的!
读博期间,他还两次去微软剑桥研究院实习,改进了Xbox体感设备Kinect认人体关节的算法,挂名两项微软专利。
DPM的公开代码,从第2版到第5版都是他维护的,第5版就是他的博士论文代码。项目页上写着:源码有问题,先看常见问题解答;还卡住,就给Ross发邮件。一年里,这套代码被下载了3445次,MIT、卡内基梅隆、牛津、谷歌的研究组都在用。他写过,把高质量的代码公开出去,是他做研究的一个基本目标。
这个习惯他一直留着。后来他三次拿到PAMI Everingham奖,这个奖专门颁给"无私地为整个视觉圈做出贡献"的人,他三次的理由分别是参与开发深度学习框架Caffe、写出检测软件Detectron、参与建成COCO数据集。
2012年4月,他博士毕业,9月去了加州大学伯克利分校,跟着计算机视觉教授Jitendra Malik做博士后。他后来写,那是"两年美好得难以置信"的博士后。
R-CNN:三个月,追平读博四年
2012年,多伦多大学的AlexNet在ImageNet认图比赛上大胜,错误率比第二名低了一大截。可它做的只是认图:一张图,给一个答案。
那年秋天,在欧洲计算机视觉大会ECCV的ImageNet比赛研讨会上,大家争得很凶。R-CNN的论文后来这样概括争论的焦点:在ImageNet上认图认得这么好,能不能搬到PASCAL上去找东西?
何恺明的讲稿里,引了计算机视觉学者Alyosha Efros当时的一句话:
那干脆在PASCAL VOC上试试深度学习,这事不就不用吵了?
在伯克利,Girshick和Jeff Donahue、Trevor Darrell、Malik一起试了。2013年11月11日,他们把论文挂到网上,第一版的摘要开头是一个问题:一个在ImageNet上练出来、只会给整张图分类的大网络,能不能被"哄"着去PASCAL里找东西?
紧跟着一句:我们证明,答案是能。
他们的做法分两步。先不急着让神经网络上场,而是用一个叫"选择性搜索"的老办法,在图上圈出大约2000个"看着像有东西"的框;再把每个框里的那块图缩成一样大,一个一个送进神经网络,让它判断:是飞机吗?是人吗?是电视吗?
比起拿框在图上挨个挪,这样要看的框少了两个数量级,也就是一百倍左右。
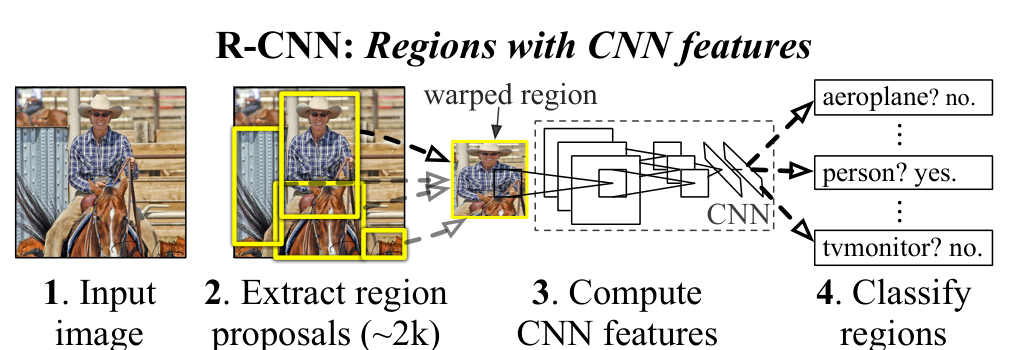
▲R-CNN的四步:输入照片,圈出约2000个候选框,每个框送进神经网络,再判断是不是飞机、是不是人、是不是电视(图源:Girshick等,R-CNN论文图1)
名字也是这么来的:R-CNN,就是"候选区域"(Region)加上"卷积神经网络"(CNN)。
成绩出来,在2010年那一届PASCAL VOC的题目上,按检测比赛的打分(满分100),DPM得33.4分,R-CNN得53.7分。
论文的对比表里,DPM第5版那一行引的参考文献,第一作者是R. Girshick。
被比下去的,是他自己读博做的那一套。
2013年11月22日,R-CNN挂上网才十来天,他在申请大学教职,给学校写的研究陈述里,提到了这项工作:
只用了三个月,我们就取得了我读博四年同样幅度的进步。
这份研究陈述今天还能找到。它链在他现在个人主页的源代码里,网页上看不见,只有翻源代码的人才看得到。旁边一行注释写着:留着它,以防你真会来翻。
在另一场更大的比赛上,R-CNN也赢了。2013年ImageNet的检测题有200类,此前最好的成绩是24.3分,来自LeCun(后来拿了图灵奖)团队做的OverFeat,它用的正是挨个挪框的办法。R-CNN得了31.4分。
提速:从一张图47秒,到一秒45张
R-CNN准,可是慢。2000个框,就要让神经网络从头算2000遍。论文自己也承认,OverFeat比它快9倍左右,提速"留作以后的工作"。后来换上更深、更准的VGG16网络,在显卡上处理一张图要47秒。
这个"以后",他自己来做。
2015年4月30日,他在微软研究院发了Fast R-CNN,论文署名只有他一个人。办法是:整张图只让神经网络算一遍,再从算好的结果上,把每个框对应的那一块直接取出来用。不算圈框的时间,处理一张图从47秒降到0.32秒;训练一个模型,从84个小时降到9.5个小时。
这样一来,最慢的反倒成了第一步:用老办法圈那2000个框,在电脑处理器上一张图还要2秒左右。
35天后,6月4日,Faster R-CNN挂上网,作者是任少卿、何恺明、Girshick和孙剑。任少卿当时是中国科学技术大学的学生,在微软研究院实习。
这回,连框也交给神经网络自己挑。在算好的结果上,每个位置预先摆好9个参考框,3种大小、3种长宽比,一张1000×600的图上一共摆了2万个左右。每个参考框只回答两个问题:里面有没有东西?框该往哪挪、放大还是缩小?
挑框几乎不再花时间。连挑框带认,一张图0.2秒,一秒能处理5张;要细看的框,从2000个减到了300个。何恺明在讲稿里给这一页起的标题是:全部交给深度学习。
又过了4天,6月8日,另一篇论文挂上网,名字叫YOLO:You Only Look Once,你只看一眼。
第一作者Joseph Redmon是华盛顿大学的博士生,Girshick排第三。YOLO干脆不挑候选框了:把图切成7×7的格子,一样东西的中心落在哪个格子,就归哪个格子管;每个格子猜两个框,再说出这一格是什么。整张图只出98个框,看一眼,答案全出来。
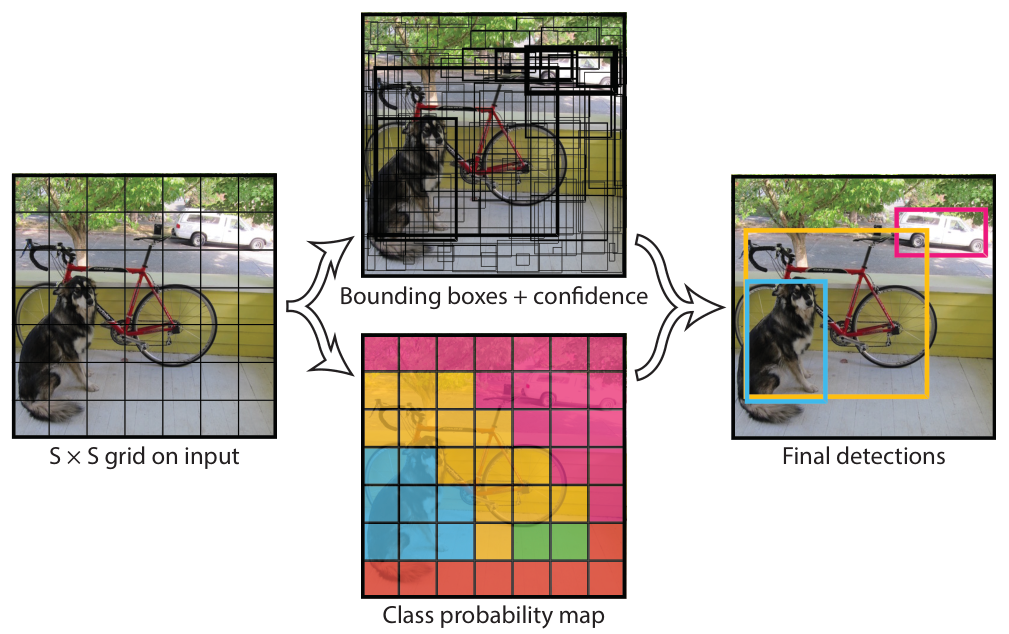
▲YOLO把图切成格子(左),每个格子猜几个框(上)、说出这一格是什么(下,不同颜色代表不同类别),合起来就是最后的结果(右)(图源:Redmon等,YOLO论文图2)
它一秒能处理45张图,从拿到图到出结果不到25毫秒,视频可以边放边找。代价是没那么准:同一份考卷,YOLO得63.4分,Faster R-CNN得73.2分。
找东西的办法从此分成两家:先挑框、再细看的,准;一眼看完的,快。两家的开山论文,作者栏里都有他。
2017年,他又和何恺明等人在Faster R-CNN上加了一个分支,框出东西的同时,把它的轮廓也描出来。这就是Mask R-CNN,拿了当年ICCV的最佳论文。
此后在Facebook,两人又合写了好几篇论文。何恺明后来的代表作MAE,署名的最后一位也是Girshick。
YOLO的第一作者,后来不做了
Redmon是个怪人。他的简历做成了动画片《小马宝莉》的样子,通篇管自己叫"这只小马",里面写着,大学时在国际大学生程序设计竞赛ICPC的波士顿预选赛上,连续两年拿了第三。
2018年,他写YOLO第三版的技术报告,开头是:有时候,一整年你就是在应付差事,我这一年没做多少研究,在推特上耗了不少时间。
报告的结尾却很认真:计算机视觉已经被用到了一些让人起疑的地方,做研究的人,至少有责任想一想自己的工作可能造成什么伤害。
2020年2月20日,他在推特上说,自己已经不做计算机视觉研究了:
我看到了我的工作带来的影响。我热爱这份工作,但军事用途和隐私问题,最后让我没法再视而不见。
2026年,YOLO拿下CVPR的时间检验奖。获奖名单上,排第一的还是他的名字。
今天:摄像头、PyTorch,和NOAI大纲
如今还在不断推出新版YOLO的,有一家公司叫Ultralytics,2026年1月发布了YOLO26。创始人Glenn Jocher在2026年10月的一次采访里说,他们的YOLO在GitHub上有12.3万颗星,Python包被下载了2.05亿次,每天要跑大约25亿次,用在机器人、医疗、制造、农业、环境监测上。
他举的一个客户,用YOLO在海洋能源设施周围自动认水下的野生动物,每天看录像的时间,从一整天缩到了一两个小时。
先挑框再细看的那一家,也一直有人用。PyTorch自带的视觉工具库torchvision里,目标检测的官方示例代码,调用的就是Faster R-CNN。Girshick当第一作者写的检测软件Detectron,后来被Meta用PyTorch重写成Detectron2,在GitHub上有3.5万颗星,说明里写着,它支撑着Facebook内部的研究项目和实际产品。
孩子备考NOAI,也会碰到它们。NOAI 2027年学术大纲讲目标检测,要求了解的代表模型,第一个就是YOLO,后面是SSD和DETR。
还卡在哪:只认得学过的那几样
YOLO的论文里,有一张图专门拿名画去考它。《呐喊》里那个捂着脸的人,被框了出来,标着"人";一幅抱着猫的《蒙娜丽莎》,人和猫各套了一个框。
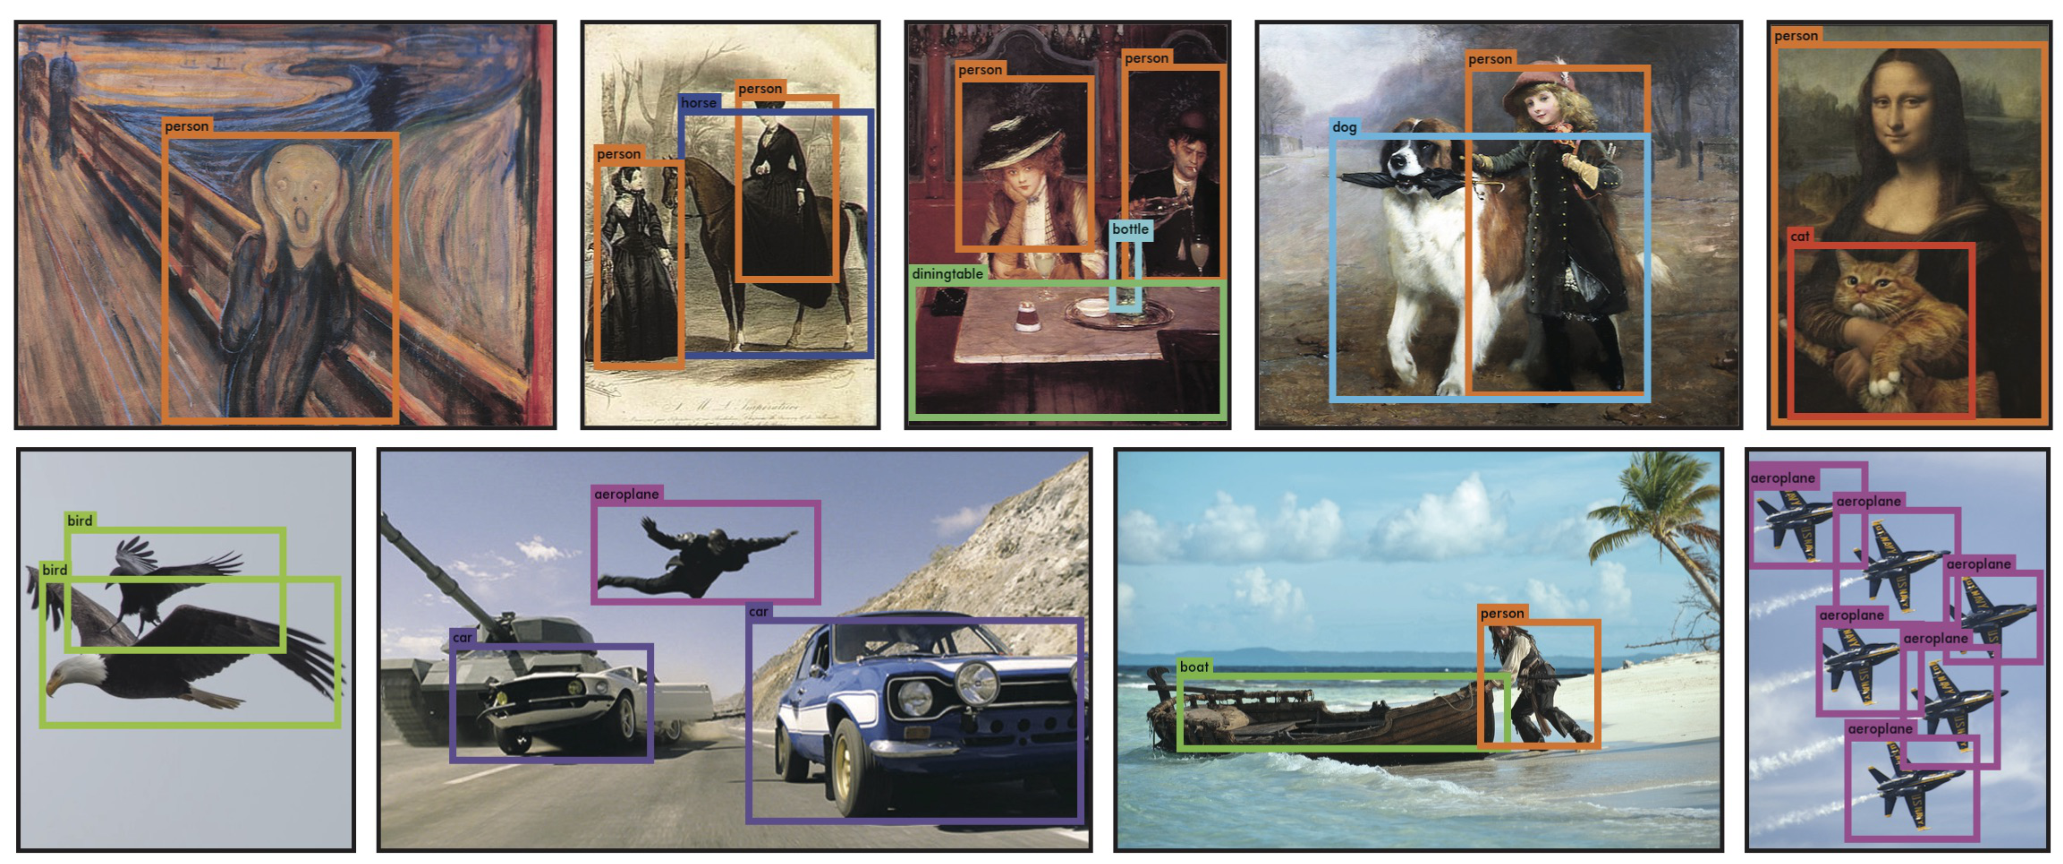
▲YOLO在名画和网上图片里找东西。下排第二张,半空中那个人被标成了"aeroplane"(飞机)(图源:Redmon等,YOLO论文图6)
同一张图里,还有一张网上找来的照片:一个人张开双臂飞在半空,YOLO给他标的是"飞机"。论文的图注老老实实写着:大部分都准,不过,它确实把一个人当成了飞机。
更大的麻烦,是这些模型只认得学过的那几样。今天检测最常用的考卷是COCO数据集,Girshick也是作者之一,收的是"4岁小孩一眼就认得"的东西,考的是80类。
生活里的东西远不止80类。2019年,Girshick和同事又建了一个新数据集LVIS,1000多类(正式版1203类),里面不少东西难得见上几回。论文里写:这种又多又稀的"长尾"躲不掉,多标一些图,只会冒出更多没见过的罕见类别。
他们把当时的主力模型Mask R-CNN原样拿来考。训练时只见过1到10张图的那些罕见东西,它只得了0.8分(满分100),论文原话是"接近零";常见的东西,它能得25.3分。
小东西也难找。YOLO的论文自己就写了:成群的小东西,比如一群鸟,它找不好。到了2026年,YOLO26里最大的型号,在COCO上找大东西能得73.3分,找小东西只有41.8分。这里的小东西,指的是在画面里不到32×32个像素点的东西。
新一代的办法,是用一句话告诉它找什么。2025年11月,Meta发布SAM 3:输入一个短词,比如"黄色校车",它就把图片和视频里所有的黄色校车都找出来、抠出来。它的考卷上有20.7万个不同的说法,它的成绩,只有人类的74%。
从照片里的猫,到屏幕上的按钮
2023年底,Girshick离开了Meta,他在那里待了八年,进去的时候它还叫Facebook。2024年初,他加入微软联合创始人保罗·艾伦出资创办的艾伦人工智能研究所(Ai2),头衔是杰出研究科学家,研究兴趣写的是:视觉、语言和行动。
2024年12月,他把主页上的头衔改成了"探索者",下面写:暂停研究,去探索一件新的、让人兴奋的事。敬请期待。
这件事叫Vercept,一家西雅图的创业公司,2024年11月注册,五个创始人都出自Ai2。他们做的产品叫Vy:装在电脑上,能像人一样看懂屏幕。你操作一遍给它看,以后说一句话,它就自己把同样的事再做一遍。种子轮融资1600万美元,谷歌前CEO埃里克·施密特、谷歌首席科学家Jeff Dean都投了钱。
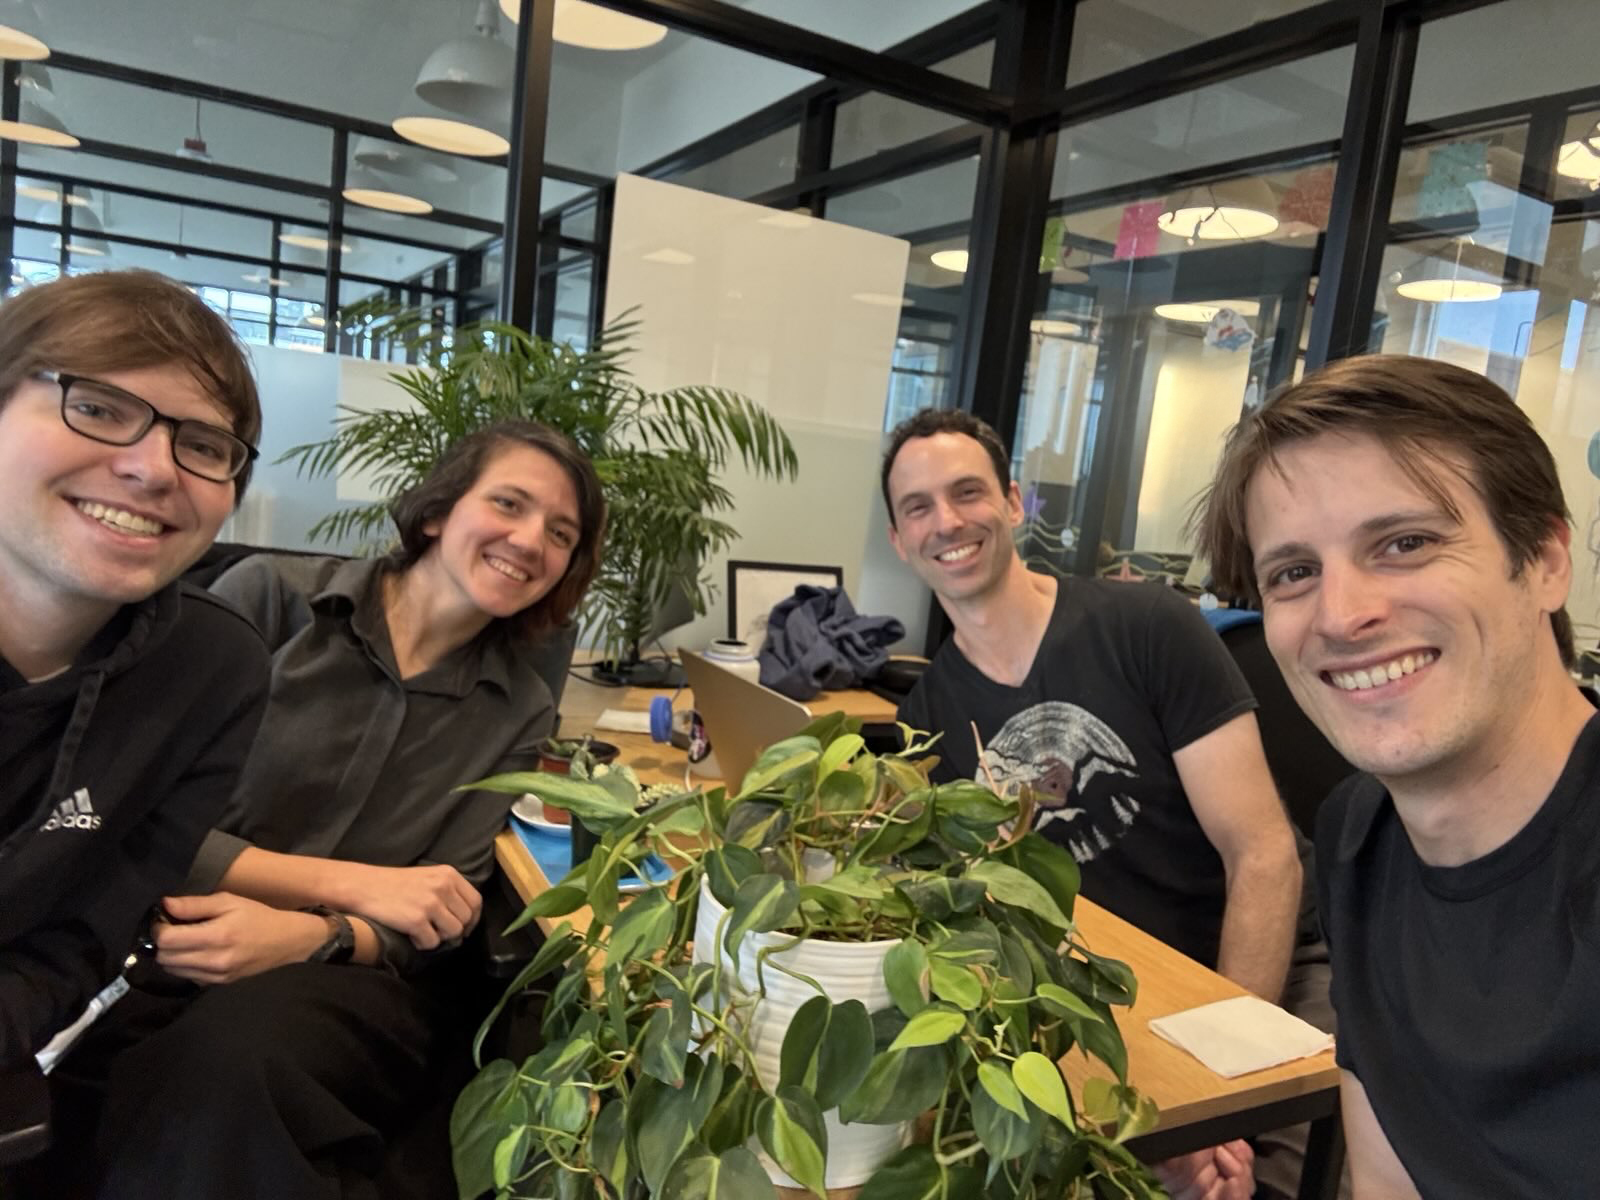
▲Vercept的四位创始人,左起:Matt Deitke、Kiana Ehsani、Ross Girshick、Luca Weihs(图源:Vercept)
2025年夏天,创始人之一、24岁的Matt Deitke接到了扎克伯格的电话。据《纽约时报》报道,Meta先开出四年约1.25亿美元,他没去;扎克伯格亲自来见他,把价码翻到四年约2.5亿美元。这回他去了。Vercept的CEO在网上发帖说:明年我们去Matt的私人岛上找他。
剩下的人接着干。2026年2月25日,做AI助手Claude的公司Anthropic宣布收购Vercept,为的是加强Claude操作电脑的本事。公告点了三位联合创始人的名字,其中就有Girshick,说他们多年来一直在琢磨:AI怎么在人每天用的那些软件里看清楚,再动手。
要替人点鼠标,AI先得看清屏幕上按钮在哪、输入框在哪。
一个月后,3月25日,Vy停止服务。三位创始人在告别信里写:使命没有变,只是找到了一个更大的家。
如今,他的个人主页上没有写职位。名字底下只有一行:aspiring climbing bum,立志当个攀岩流浪汉。
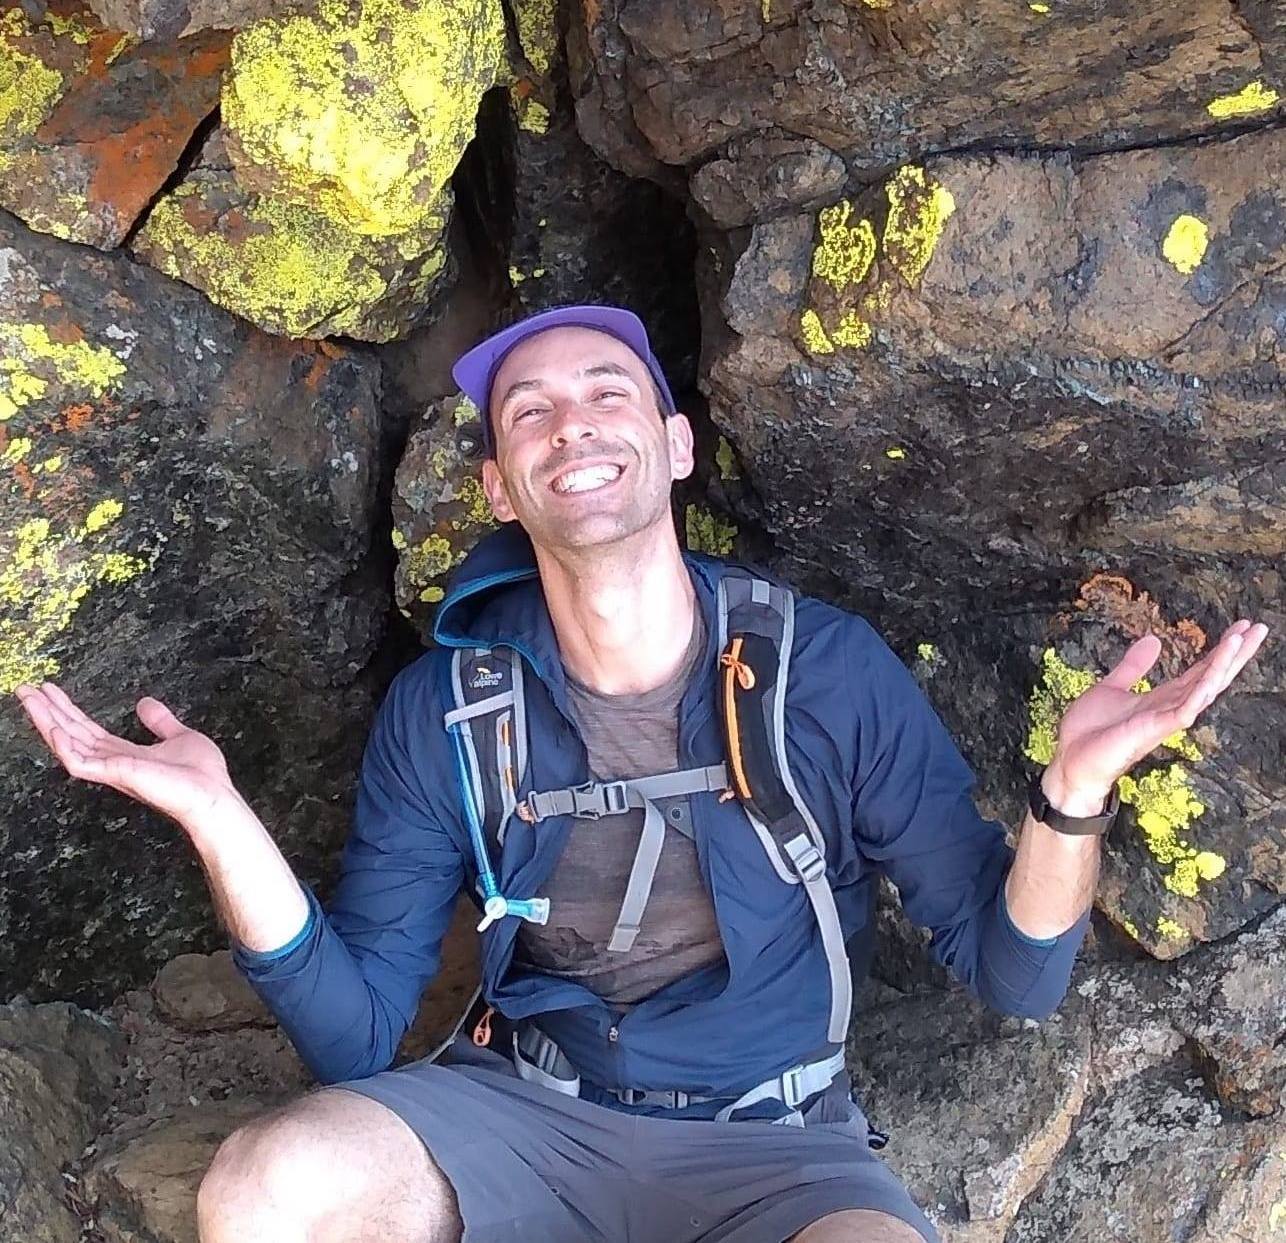
▲他主页上,挂在这行头衔旁边的照片(图源:本人个人主页)
2023年到2024年,他的个人简介最后一句一直是:不做研究的时候,Ross通常在攀岩,琢磨怎么把手上那条还没爬下来的难线,一口气爬完。
本文由 NOAI Club(noaiclub.cn)整理,作者:带孩子玩AI的江哥。发布于 2026-10-31,更新于 2026-11-04。